

Сертификации по кибербезопасности ИИ: отставание от практики

Table of Contents
Мы сдавали экзамены. Мы их прошли. Мы получили сертификаты, но остались разочарованы. Я хочу точно объяснить, почему.
Это не критика людей, которые создали эти программы. Им приходится работать с неполными материалами. Безопасность ИИ как дисциплина еще молода. Исследования атак развиваются быстрее защитных инструментов. Рамки управления появились раньше инженерных рекомендаций.
Проблема в разрыве между тем, чему учат сертификации, и тем, что нужно знать для защиты рабочих систем ИИ.
Три уровня, которые часто путают
Прежде чем говорить о пробелах, полезно разделить то, что уже существует.
Первый уровень — управление. Такие документы, как NIST AI Risk Management Framework (AI RMF 1.0, 2023), ISO/IEC 42001:2023 и EU AI Act, работают на уровне организации и процессов. Они описывают управление рисками ИИ, структуру надзора и документирование ответственности. Они намеренно сосредоточены на управлении, а не на предписании конкретных мер контроля. Таков замысел.
Второй уровень — таксономия угроз. MITRE ATLAS описывает методы противодействия системам ИИ в том же формате, что и ATT&CK. OWASP Top 10 for Large Language Model Applications перечисляет наиболее важные классы атак на развернутые LLM. Эти документы называют атаки и описывают их механизм. Они не предписывают защиту.
Третий уровень — технические рекомендации. Сюда входят Google’s Secure AI Framework (SAIF), Microsoft’s AI Security SDL, OWASP AI Exchange, NIST AI 600-1 (Generative AI Profile) и документация по безопасности отдельных поставщиков, включая Anthropic, OpenAI и Meta. Они дают инженерные рекомендации по безопасному развертыванию, оценке и контролю во время выполнения.
Большинство сертификаций по управлению ИИ подробно охватывают первый уровень. Второй упоминают обзорно. Третий затрагивают редко.
Что охватывают сертификации
Доступные сегодня сертификации по управлению и безопасности ИИ, в том числе IAPP AI Governance Professional (AIGP), ISACA AI Fundamentals Certificate, сертификации ISO 42001 и CompTIA AI+, охватывают схожий набор тем.
Вы изучаете NIST AI RMF и то, как соотнести его четыре функции: Govern, Map, Measure и Manage — с развертыванием ИИ в своей организации. Вы изучаете уровни риска EU AI Act и процедуру оценки соответствия для систем высокого риска. Вы узнаете о предвзятости, справедливости, прозрачности и подотчетности как принципах управления. Вы учитесь писать политики управления ИИ и проводить оценку воздействия.
Это реальные навыки. Организациям нужны люди, которые понимают рамки управления и могут прочитать NIST AI RMF, чтобы понять, что он требует создать.
С той же глубиной сертификации не учат:
- Как атакующие сейчас компрометируют системы ИИ в рабочей среде
- Как практически устроена эшелонированная защита от prompt injection и почему ни одна отдельная мера его не устраняет
- Как до развертывания проверять целостность моделей
- Что включает red teaming для ИИ и как определить его масштаб
- Как до запуска оценивать поведение модели при адверсариальных входных данных
- Как выглядит наблюдаемость ИИ во время инференса
- Чем реагирование на инциденты ИИ отличается от стандартных планов IR
- Что требуется для защиты агентов ИИ с доступом к инструментам и внешним интеграциям
NIST AI RMF — это управление, а не инженерия
NIST AI RMF — хорошо составленный документ. NIST разработал его как технологически нейтральную, не привязанную к отрасли структуру, применимую к разным подходам к разработке ИИ. Поэтому она подходит для широкого круга задач.
Это также означает, что документ не предписывает технические меры для конкретных классов атак. Если организация полностью примет AI RMF и сопоставит все его функции со своим развертыванием ИИ, у нее появятся документированные процессы управления рисками. Но у развернутой языковой модели не обязательно появится защита от prompt injection.
NIST признает это. NIST AI 600-1, Generative AI Profile, выпущенный в 2024 году, расширяет AI RMF для генеративного ИИ и больших языковых моделей. Он рассматривает prompt injection, отравление данных и информационные угрозы с большей детализацией, чем базовый AI RMF. Если сертификация охватывала базовый AI RMF без AI 600-1, вы пропустили документ, наиболее важный для развернутых сейчас систем.
ISO 42001 и сравнение с системой управления
ISO 42001:2023 — стандарт системы управления ИИ. Он задает структуру управления разработкой и развертыванием ИИ в организации. Специалисты по безопасности заметят сходство с ISO 27001 для защиты информации.
ISO 27001 широко применяется. Сертифицированные организации все равно подвергаются взломам. Сертификация фиксирует, что система управления существует, следует определенному процессу и проходит проверку. Она не подтверждает устойчивость управляемых систем к направленным против них атакам.
ISO 42001 обеспечивает организационную дисциплину. Сертификация показывает заинтересованным сторонам, что процессы ИИ документированы, проверяются и подпадают под управление. Она не доказывает, что развернутые модели дают стабильные результаты в условиях атак, агенты соблюдают заданные границы доверия, а дообученные модели созданы на проверенных данных.
Это тот же пробел, что и у ISO 27001. В традиционной кибербезопасности мы научились с ним работать. Не следует делать вид, что сертификации по управлению ИИ закрывают этот пробел, если у них то же структурное ограничение.
EU AI Act требует результатов, но не задает инженерных спецификаций
EU AI Act распределяет системы ИИ по уровням риска: неприемлемый (запрещен), высокий (требуется оценка соответствия), ограниченный (обязательства по прозрачности) и минимальный (специальных требований нет).
Системы высокого риска, в том числе в критической инфраструктуре, биометрической идентификации, отборе персонала, образовании и правоохранительной деятельности, должны иметь техническую документацию, человеческий надзор и подтвержденную устойчивость. Закон прямо требует, чтобы такие системы выдерживали попытки изменить их поведение с помощью адверсариальных манипуляций.
Это требование записано в законе. Закон намеренно определяет результаты, а не технические меры. Для демонстрации устойчивости ко всем адверсариальным воздействиям в разных условиях развертывания пока нет согласованных ответов для каждого типа систем и сценария.
Сертификации по EU AI Act готовят к классификации систем ИИ, составлению технической документации и разработке протоколов надзора. Они готовят к аудиту. Инженерная работа по созданию системы, соответствующей требованиям устойчивости закона, относится к другой дисциплине и не входит в нынешний охват сертификаций.
Какие атаки действительно угрожают системам ИИ
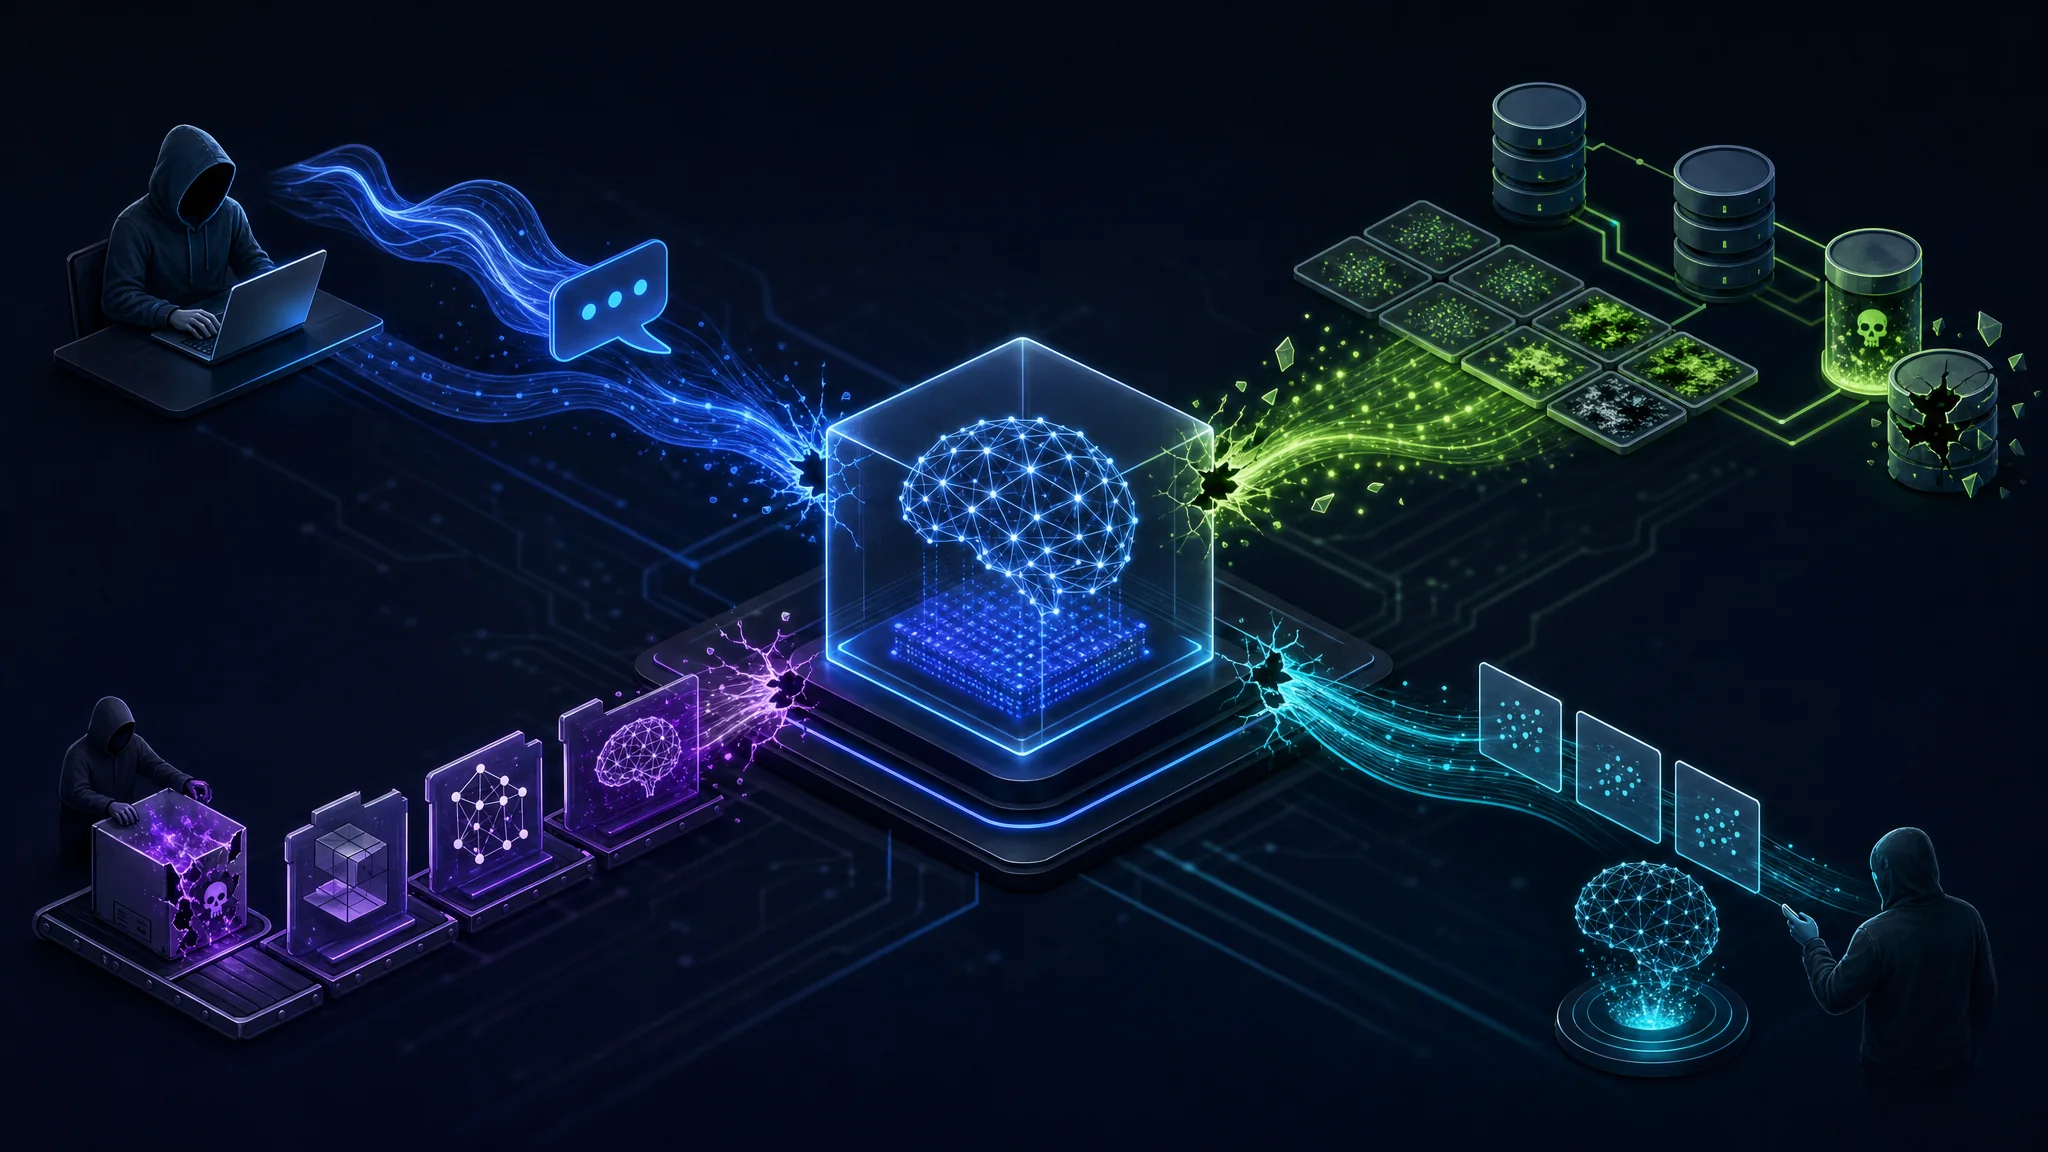
MITRE ATLAS и OWASP LLM Top 10 описывают практическую картину угроз. Эти источники перечисляют атаки с полезной степенью подробности. Рамки управления упоминают угрозы более абстрактно. Ниже приведены сведения из специализированных источников по безопасности.
Prompt injection подает языковой модели входные данные, которые переопределяют или искажают системные инструкции. Прямая инъекция нацелена на вход модели. Косвенная инъекция прячет вредоносные инструкции в содержимом, которое модель получает, обрабатывает или обобщает. Ваш конвейер RAG читает документ под контролем атакующего и выполняет скрытые в нем инструкции. Агент браузера открывает страницу атакующего и следует встроенным указаниям. Бот поддержки обобщает статью, в которой сказано игнорировать правила безопасности.
На 2026 год универсально эффективной защиты от prompt injection нет. Эшелонированная защита снижает риск: фильтрация входных данных, проверка выходных данных, ограниченные привилегии инструментов, изолированные среды выполнения и подтверждение человеком важных действий. Ни одна мера не устраняет весь класс атак. NIST, OWASP, Anthropic, OpenAI, Google и Microsoft рекомендуют несколько уровней контроля, а не одно решение.
Отравление обучающих данных добавляет вредоносные примеры, чтобы ухудшить поведение модели, внедрить бэкдоры или создать поведение, включающееся по триггеру. Признаки успешного отравления часто отсутствуют до тех пор, пока модель не получит определенный триггерный вход. Если организация дообучает модели на пользовательских материалах, полученных документах или сторонних наборах данных без проверки их происхождения, она подвергается этому риску.
Компрометация цепочки поставки модели — угроза, которую большинство организаций рассматривает по остаточному принципу. Репозитории моделей часто распространяют исполняемый код вместе с весами. Небезопасные форматы сериализации, такие как pickle, неоднократно создавали риски цепочки поставки. Пакеты при загрузке модели могут устанавливать уязвимые зависимости. Похоже, многие организации проверяют модели из публичных репозиториев значительно менее тщательно, чем программные зависимости. Поверхность атаки сопоставима с npm, но культура безопасности в этой области еще только формируется.
Извлечение модели позволяет атакующим восстановить функционально схожую модель с помощью повторных запросов инференса к вашему API. Это приводит к потере интеллектуальной собственности и помогает изучать модель офлайн для разработки более целевых атак.
Инференс членства позволяет атакующим с разной степенью уверенности определить, входили ли конкретные записи в обучающий набор. Это зависит от архитектуры модели и режима обучения. Такая возможность создает риск конфиденциальности для организаций, обучавших модели на персональной информации.
Адверсариальные входные данные изменяют результаты модели с помощью специально подобранных возмущений. Эту технику чаще всего изучают для классификации изображений, но она применяется к тексту, аудио и мультимодальным системам. Если ИИ принимает решения о выявлении мошенничества, кредитоспособности, медицинских изображениях или физическом доступе, адверсариальная устойчивость — свойство безопасности, которое нужно проверять, а не просто документировать.
Утечкам данных через системы ИИ следует уделять отдельное внимание. Конвейеры RAG раскрывают документы из базы знаний, иногда пользователям без права доступа. Утечка prompt из системных инструкций раскрывает рабочие подробности, которые должны оставаться конфиденциальными. В многопользовательских развертываниях ИИ нужна изоляция, важность которой инженеры традиционной безопасности приложений иногда недооценивают. Это практические риски, регулярно возникающие в развернутых системах.
Агенты ИИ полностью меняют поверхность атаки
Большинство сертификаций по безопасности ИИ написаны тогда, когда под системами ИИ главным образом понимались чат-боты и классификаторы. В 2026 году корпоративный ИИ все чаще означает агентов.
Агенты отличаются от чат-ботов в одном важном с практической точки зрения аспекте: они выполняют действия. Агент с доступом к электронной почте, внутренним базам данных, файловым системам, браузеру и средам выполнения кода — не чат-бот с дополнительными функциями. Это автономный процесс со значительным доступом к реальным системам, который действует на основе выводов языковой модели.
OWASP поддерживает отдельный Agentic AI Top 10, потому что модель угроз для агентов настолько отличается от LLM-чатов, что требует отдельной документации.
Prompt injection в контексте агента приводит не к нежелательному текстовому ответу, а к нежелательному действию. Косвенная инъекция в полученном документе может приказать агенту удалить файлы, похитить данные или отправить электронные письма. Последствие — не неподходящий ответ, а несанкционированное действие в системах, к которым у агента есть доступ.
Поверхность атаки агентов включает:
- Ограничения вызова инструментов: ограничен ли агент минимальным набором инструментов, нужным для каждой задачи
- Область учетных данных: ограничены ли учетные данные агента необходимым для каждой задачи
- Обратимость действий: требуют ли важные действия подтверждения человека до выполнения
- Фильтрация выходных данных: проверяются ли результаты агента до запуска последующих действий
- Песочница: предотвращает ли среда выполнения нежелательный доступ к подключенным системам
Большинство сертификаций по управлению ИИ не рассматривают проектирование безопасности агентов с такой степенью детализации.
Model Context Protocol создает новую корпоративную поверхность атаки
Model Context Protocol (MCP) стал широко применяемым стандартом подключения агентов ИИ к внешним инструментам, источникам данных и службам. MCP-серверы предоставляют функции, которые агенты обнаруживают и используют. Интеграция быстрая и гибкая, но последствия для безопасности не всегда получают такое же внимание.
Риски MCP включают:
- Вредоносные MCP-серверы, которые искажают описание своих возможностей и выполняют нежелательные действия
- Отравление инструментов: легальный MCP-сервер возвращает данные под контролем атакующего и встраивает инструкции в вывод, который должен содержать только данные
- Избыточные привилегии инструментов: интеграции MCP имеют права сверх необходимых задаче
- Путаницу границ доверия: агент считает инструкции подключенных MCP-инструментов равными инструкциям пользователя
Организациям, развертывающим агентов с интеграциями MCP, нужны рамки для оценки доверия к MCP-серверам, аудита разрешений инструментов и проверки того, что ответы инструментов рассматриваются как данные, а не инструкции.
Оценка — это практическая работа, которую сертификации пропускают
Red teaming ИИ и наборы оценок заменяют статические проверки безопасности как основной способ понимать риск модели до развертывания и после него.
Red teaming ИИ включает:
- Структурированное адверсариальное тестирование поведения модели на известных методах атак
- Проверку jailbreak по установленным наборам атакующих prompt
- Тестирование адверсариальной устойчивости с измерением изменений выходных данных при измененных входах
- Регрессионное тестирование поведения между версиями модели
- Оценку по опубликованным наборам тестов безопасности
NIST, Anthropic, OpenAI, Microsoft, Google и CISA рекомендуют red teaming для ИИ перед развертыванием систем высокого риска. Это становится стандартным ожиданием, а не необязательной практикой.
Ни одна из текущих сертификаций по управлению ИИ не готовит специалистов к определению масштаба, проведению или интерпретации red teaming развернутой модели или системы агентов. Сертификации описывают, что такое red teaming, но не учат его проводить.
Наблюдаемость ИИ — отдельная дисциплина
Традиционное журналирование безопасности нельзя напрямую перенести на системы ИИ. Для мониторинга LLM или агента в рабочей среде нужен сбор и анализ других данных.
Инфраструктура наблюдаемости ИИ охватывает:
- Телеметрию prompt и выходных данных для обнаружения аномалий и нарушений политик
- Журналы вызовов инструментов агентами, включая названия инструментов и аргументы
- Мониторинг качества получения данных в конвейерах RAG
- Обнаружение и классификацию попыток jailbreak
- Мониторинг согласованности выходов для выявления изменений между версиями модели
- Отслеживание частоты галлюцинаций в приложениях, где важна фактическая точность
- Задержки, которые могут указывать на попытки prompt injection увеличить размер контекста
Это формирующаяся дисциплина. В 2026 году у большинства организаций, использующих ИИ, наблюдаемость компонентов ИИ значительно хуже, чем традиционной инфраструктуры. Большинство сертификаций по управлению не описывает, какой должна быть достаточная наблюдаемость систем ИИ.
Реагирование на инциденты ИИ отличается от обычного IR
При компрометации традиционной системы план IR предусматривает сдерживание, криминалистический анализ и восстановление. Инциденты ИИ ставят вопросы, на которые стандартный план не отвечает.
Подготовьте планы на случай таких вопросов до возникновения инцидента:
- Как определить, подверглась ли модель отравлению во время дообучения
- Как проверить, использовали ли поиск RAG для выдачи содержимого под контролем атакующего
- Как установить, выполнял ли агент несанкционированные действия и каков был их масштаб
- Как проверить, изменило ли обновление модели от стороннего поставщика поведение с точки зрения безопасности
- Как установить поведение модели до инцидента, чтобы сравнить его с поведением после
Это требует подготовки до инцидента, заблаговременной настройки журналов и телеметрии, а также планов реагирования для ИИ, предусматривающих анализ поведения модели, а не только сетевого трафика и журналов конечных устройств.
Проблема обновления сертификаций
Одна из структурных причин отставания сертификаций — изменения безопасности ИИ происходят быстрее, чем циклы обновления учебных материалов.
Security+, CISSP и ISO 27001 охватывают области, меняющиеся годами. Основные поверхности атаки сетей, конечных устройств и приложений относительно стабильны. Методы атак на ИИ меняются за месяцы. Методы prompt injection, адверсариальные атаки и поверхности атак на агентов в 2026 году отличаются от тех, что существовали при запуске первых сертификаций по ИИ в 2023 и 2024 годах.
Органы сертификации обновляют материалы по расписанию. OWASP LLM Top 10 выпустил серьезное обновление в первый год. Когда создавались многие нынешние сертификации по ИИ, MCP еще не считался корпоративной угрозой. Рамки безопасности агентного ИИ появились позже большинства действующих программ.
Это структурная проблема, а не отсутствие намерений. Регулярно читайте первоисточники, а не считайте сертификацию неизменным набором знаний.
Что следует включить в сертификацию по безопасности ИИ
Чтобы программы сертификации соответствовали современной практике безопасности ИИ, им нужно охватывать:
- Эшелонированную защиту от prompt injection: фильтрацию входов, проверку выходов, ограничение инструментов, песочницу и подтверждение действий человеком, а также документированные ограничения каждого метода
- Проверку цепочки поставки моделей: риски небезопасной сериализации, требования SBOM, документацию происхождения и проверку подписанных артефактов
- Архитектуру безопасности агентов ИИ: границы доверия, минимальные права инструментов, обратимость действий и требования мониторинга
- Безопасность MCP и внешних интеграций: оценку доверия к серверам инструментов, аудит разрешений и разделение данных и инструкций
- Оценку и red teaming: определение объема адверсариальной проверки, существующие тесты и наборы данных, интерпретацию результатов
- Наблюдаемость ИИ: необходимые журналы и телеметрию и их применение для обнаружения инцидентов и реагирования
- Реагирование на инциденты ИИ: предварительное планирование сценариев, сбор доказательств о поведении модели и особые требования к восстановлению
- Предотвращение утечек данных: изоляцию RAG, конфиденциальность prompt, контроль доступа для нескольких арендаторов и фильтрацию выходных данных
Что сделать прямо сейчас
Если вы отвечаете за системы ИИ в своей организации:
Прочитайте OWASP Top 10 for Large Language Model Applications и OWASP Agentic AI Top 10. Они бесплатны и содержат больше практических подробностей, чем нынешние платные программы сертификации.
Перед следующей сессией моделирования угроз для компонента ИИ изучите MITRE ATLAS. До утверждения проекта развертывания выясните, какие тактики противника применимы к вашей архитектуре.
Прочитайте NIST AI 600-1. Он специально расширяет базовый AI RMF для генеративного ИИ и гораздо актуальнее для развертывания LLM и агентов, чем базовая рамка сама по себе.
Изучите Google SAIF, Microsoft’s AI SDL и OWASP AI Exchange — они дают инженерные рекомендации, которых нет в рамках управления.
Проверяйте происхождение каждой модели, которую развертывает организация. Изучайте карточки моделей. Перед загрузкой весов проверяйте форматы сериализации на известные классы эксплойтов.
Сопоставьте каждого агента ИИ в своей среде с имеющимися у него правами доступа. Агент с правами чтения и записи во внутренней базе знаний, электронной почте и файловой системе усиливает последствия prompt injection. Ограничьте его учетные данные необходимыми для каждой задачи.
Требуйте red teaming для ИИ до развертывания любой модели или агента в контексте с серьезными последствиями. Считайте его обязательным.
Создайте планы реагирования на инциденты ИИ сейчас, до того как они понадобятся.
Считайте сертификацию по управлению документированием процессного уровня. Она не документирует состояние вашей безопасности.
Источники
- NIST AI Risk Management Framework (AI RMF 1.0), 2023
- NIST AI 600-1: Generative AI Profile, 2024
- NIST SP 1270: Towards a Standard for Identifying and Managing Bias in Artificial Intelligence
- ISO/IEC 42001:2023 Artificial Intelligence Management Systems
- EU AI Act, Regulation (EU) 2024/1689
- OWASP Top 10 for Large Language Model Applications, 2025
- OWASP Agentic AI Top 10
- OWASP AI Exchange
- MITRE ATLAS: Adversarial Threat Landscape for AI Systems
- Google Secure AI Framework (SAIF)
- Microsoft AI Security SDL documentation
- CISA Guidance on AI Cybersecurity, 2024
- Barreno et al., Can Machine Learning Be Secure?, 2006
- Biggio et al., Poisoning Attacks Against Support Vector Machines, 2012
- Goodfellow et al., Explaining and Harnessing Adversarial Examples, ICLR 2015
- IAPP AI Governance Professional (AIGP) program documentation
- ISACA AI Fundamentals Certificate program documentation

