Гибридный парк ИИ-агентов изнутри: Hermes, LiteLLM и Tailscale

Table of Contents
Мы развернули локальный парк GPU с выделением ресурсов под отдельные запросы и спроектировали гибридную плоскость управления. Проверенный путь начинается в LiteLLM, выбирает группу моделей и загружает одну локальную модель на одну GPU за раз. Политика уровней Hermes предложена, а артефакт конфигурации Tailscale Aperture готов к следующему интеграционному тесту. Ни одно из решений не проверено как часть единого сквозного маршрута.
Простаивающие карты майнят Pearl. Запрос ИИ приостанавливает майнинг только на выделенной карте, обслуживает запрос, выгружает модель и возвращает карту майнеру.
Основные выводы
- T0–T2 обрабатывают дорогие или сложные задачи. Эти маршруты предпочитают размещенные frontier-модели и упорядоченные цепочки резервирования.
- T3 выполняет значительную часть локальной работы. Парк распределяет планирование, программирование, проверку и обработку изображений между моделями от 4B до 12B.
- T4 выполняет большой объем локальных задач. Малые модели маршрутизируют, классифицируют, извлекают данные, создают эмбеддинги и выполняют ограниченные задачи программирования.
- Каждая GPU — отдельный ресурс. Одна карта обслуживает ИИ, пока остальные продолжают майнить.
- Локальные модели выгружены во время простоя. Между окнами запросов ни одна модель не занимает память GPU.
- Все шлюзы предоставляют один логический каталог. Общие псевдонимы распределяют работу между подходящими системами. Псевдонимы с префиксом узла сохраняют точное размещение при необходимости.
- Экспериментальный брокер не попал в промышленную эксплуатацию. Его canary обслужил запрос, но не прошел проверку корректного завершения. LiteLLM остался на проверенном пути для запросов.
- Hermes и Aperture пока подготовлены к внедрению. Целевой дизайн существует, а сквозные приемочные испытания еще не завершены.
Требования: несколько Linux-хостов с GPU, стабильные драйверы NVIDIA, tailnet Tailscale, systemd, работающий майнер, хранилище моделей и приемочные тесты для каждого маршрута модели.
Время и сложность: продвинутый уровень. Выделите несколько дней на инвентаризацию, загрузку моделей, определения служб, тестирование маршрутизации, отработку отказов и проверку восстановления майнинга на каждой карте.
Термины: tailnet — частная сеть из идентификаторов и устройств Tailscale. Псевдоним модели — стабильное имя модели, видимое клиентам. Группа моделей объединяет несколько развертываний за одним псевдонимом. Прокси пула — небольшая локальная служба, которая выделяет GPU, запускает процесс модели, а затем возвращает карту к майнингу.
Цель проектирования
Задачи агентов бывают разными. Для ремонта репозитория нужна другая модель, чем для создания заголовка, снимка экрана, эмбеддинга или метки намерения. Направлять каждую задачу самой большой модели — значит тратить деньги и локальные ресурсы. Направлять каждую задачу самой маленькой модели приводит к повторам и слабым результатам.
Мы хотели создать единый каталог с пятью диапазонами нагрузки. Политика должна обслуживать размещенные и локальные модели через привычные форматы API. Локальные GPU должны оставаться полезными между запросами ИИ.
Парк также должен работать параллельно. Хост с несколькими картами должен одновременно обслуживать несколько независимых задач. Запрос на одной карте не должен останавливать майнинг на остальных картах в корпусе.
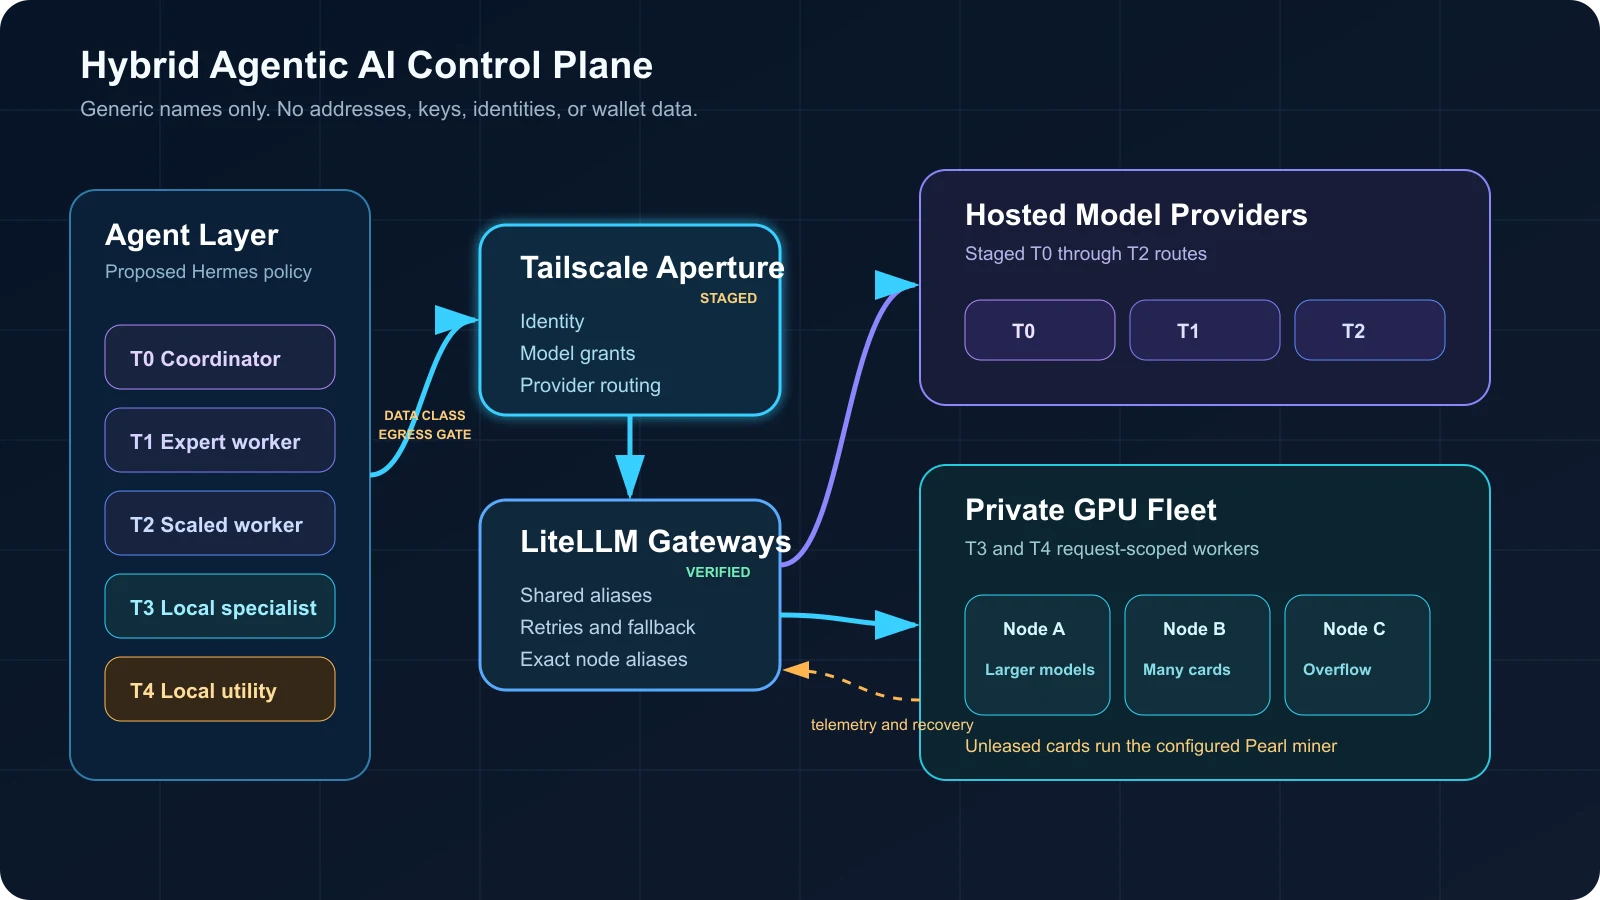
Предлагаемый и подготовленный путь управления находится над проверенным путем выполнения через LiteLLM и отдельные GPU
На схеме используются общие имена узлов. В ней нет частных адресов, личных идентификаторов, ключей доступа, данных кошелька и физических меток хостов.
Что означают T0–T4
Названия уровней — наша политика маршрутизации. Это не отраслевой стандарт, и они не описывают только размер модели.
| Уровень | Основная роль | Типичное назначение | Действия при сбое |
|---|---|---|---|
| T0 | Координатор по умолчанию и самые сложные решения | Размещенная frontier-модель рассуждений | Упорядоченная цепочка размещенных резервных моделей |
| T1 | Ценные рабочие агенты | Размещенный пул моделей с высокими возможностями | Повтор в назначенной цепочке |
| T2 | Широкий пул рабочих агентов | Быстрые размещенные модели с повышением уровня | Передать сложную задачу на T1 или T0 |
| T3 | Существенная частная локальная работа | Локальные модели 4B–12B для чата, кода, проверки и изображений | Повторить на подходящем локальном узле, затем безопасно завершить задачу с ограниченными данными |
| T4 | Узкие частые локальные задачи | Модели 0,6B–3B для маршрутизации, классификации, кода и эмбеддингов | Повторить на локальной реплике или перейти на T3 в пределах той же границы данных |
Сначала уровни описывают задачу, а затем модель. Короткая классификация с требованиями безопасности подходит для T4. Длинный план работы с репозиторием относится к T3 или выше. Сложное архитектурное решение сразу начинается на более высоком уровне, даже при коротком запросе.
Такое разделение меняет и экономику агентов. Исполнители T4 берут на себя повторяющиеся преобразования с низким риском. Исполнители T3 оставляют типичные задачи кода и анализа внутри tailnet. T0–T2 доступны для сложной работы и восстановления после отказов.
Перед каждым резервным размещенным маршрутом нужна проверка класса данных. Для общедоступных, внутренних и ограниченных задач используются отдельные цепочки. Ограниченная работа остается локальной и безопасно завершается при сбое. Повтор через границу данных требует очищенного ввода и явного разрешения пользователя или рабочего процесса. Перед вызовом размещенной модели редактирование удаляет учетные данные, секреты репозитория, закрытые результаты инструментов и конфиденциальный полученный контент.
Как Hermes будет управлять политикой задач
Hermes — предложенный агентный слой. Целевая политика назначает класс модели, запускает инструменты, делегирует работу и проходит по явным цепочкам резервирования. Hermes документирует отдельные маршруты для основной модели, вспомогательных задач, делегированных агентов и резервных моделей для конкретных задач. Также поддерживаются пользовательские OpenAI-совместимые конечные точки с базовым URL. См. руководство по конфигурации Hermes и руководство по резервным поставщикам .
Наша политика назначает задачам Hermes стабильные псевдонимы, а не физические серверы. Примеры:
t3-smart
t3-code
t3-review
t3-vision
t4-code
t4-classify
t4-router
t4-embedding
Псевдоним выражает намерение. Hermes не нужно знать, какая GPU свободна, где стоит более крупная карта и какая реплика не прошла проверку состояния. Эти решения принимают нижние уровни.
Некоторым задачам по-прежнему требуется детерминированное размещение. Идентификатор модели с префиксом узла отправляет диагностику оператора или тест производительности в выбранную систему. Отдельные разрешения Aperture должны ограничивать такие псевдонимы операторами. Обычный трафик агентов использует общие псевдонимы уровней.
Доступ к модели не защищает инструменты агента. Для развертывания Hermes нужны списки разрешенных инструментов с минимальными привилегиями, изолированные рабочие пространства, ограниченные учетные данные, контроль исходящего сетевого трафика и защита от prompt injection. Делегированные исполнители не должны получать больше доступа, чем требует их задача.
Aperture как подготовленная граница идентификации
Tailscale соединяет настроенный шлюз с узлами инференса, не открывая каждую службу в публичном интернете. Aperture подготовлен как пользовательская граница и маршрутизатор моделей. Этот маршрут еще нужно проверить сквозным приемочным тестом. В описании работы Aperture Tailscale документирует зашифрованный доступ клиента через tailnet и перенаправление к поставщику по TLS.
Aperture также отделяет доступность от разрешения. Разрешения по умолчанию запрещают доступ. Пользователю или помеченному устройству после подключения к шлюзу нужно подходящее разрешение на модель. Руководство по разрешениям Aperture объясняет аддитивную модель разрешений и источники идентификации.
Перед развертыванием подготовленная конфигурация Aperture должна соблюдать четыре правила:
- Администраторская роль закреплена за одной именованной идентичностью. Общий доступ к моделям не дает административных прав.
- Поставщики указывают точные идентификаторы моделей. Aperture не определяет модели по вышестоящей службе.
- URL поставщиков ведут на адреса tailnet. Частные имена и адреса узлов нельзя включать в статью или публичные примеры конфигурации.
- Секреты хранятся в файлах, принадлежащих службе. До развертывания установите доступ только владельцу, ограничьте сервисные учетные записи, настройте ротацию и маскирование журналов. Диагностический вывод никогда не должен показывать ключи LiteLLM, адреса tailnet, токены подписки или данные кошелька.
Aperture добавляет путь входящего запроса к базовому URL каждого поставщика.
Справочник конфигурации
предупреждает, что в корневой URL поставщика не нужно добавлять дублирующий суффикс /v1. Этот риск интеграции потребовал явного теста проверки.
Обработка изображений подготовлена для OpenAI Chat Completions с содержимым изображений. Эмбеддинги идут напрямую в частную конечную точку LiteLLM: текущая таблица self-hosted-поставщиков Aperture описывает форматы чата, а наш путь эмбеддингов зависит от конечных точек LiteLLM и llama.cpp за пределами чатового селектора. См. справочник поддерживаемых поставщиков и клиентов .
Прямому маршруту эмбеддингов нужна своя граница авторизации. Аутентификация LiteLLM, строгие разрешения Tailscale, привязка службы к интерфейсу tailnet и правила межсетевого экрана хоста должны ограничивать доступ утвержденными идентификаторами или тегами служб. Один частный адрес не заменяет политику авторизации.
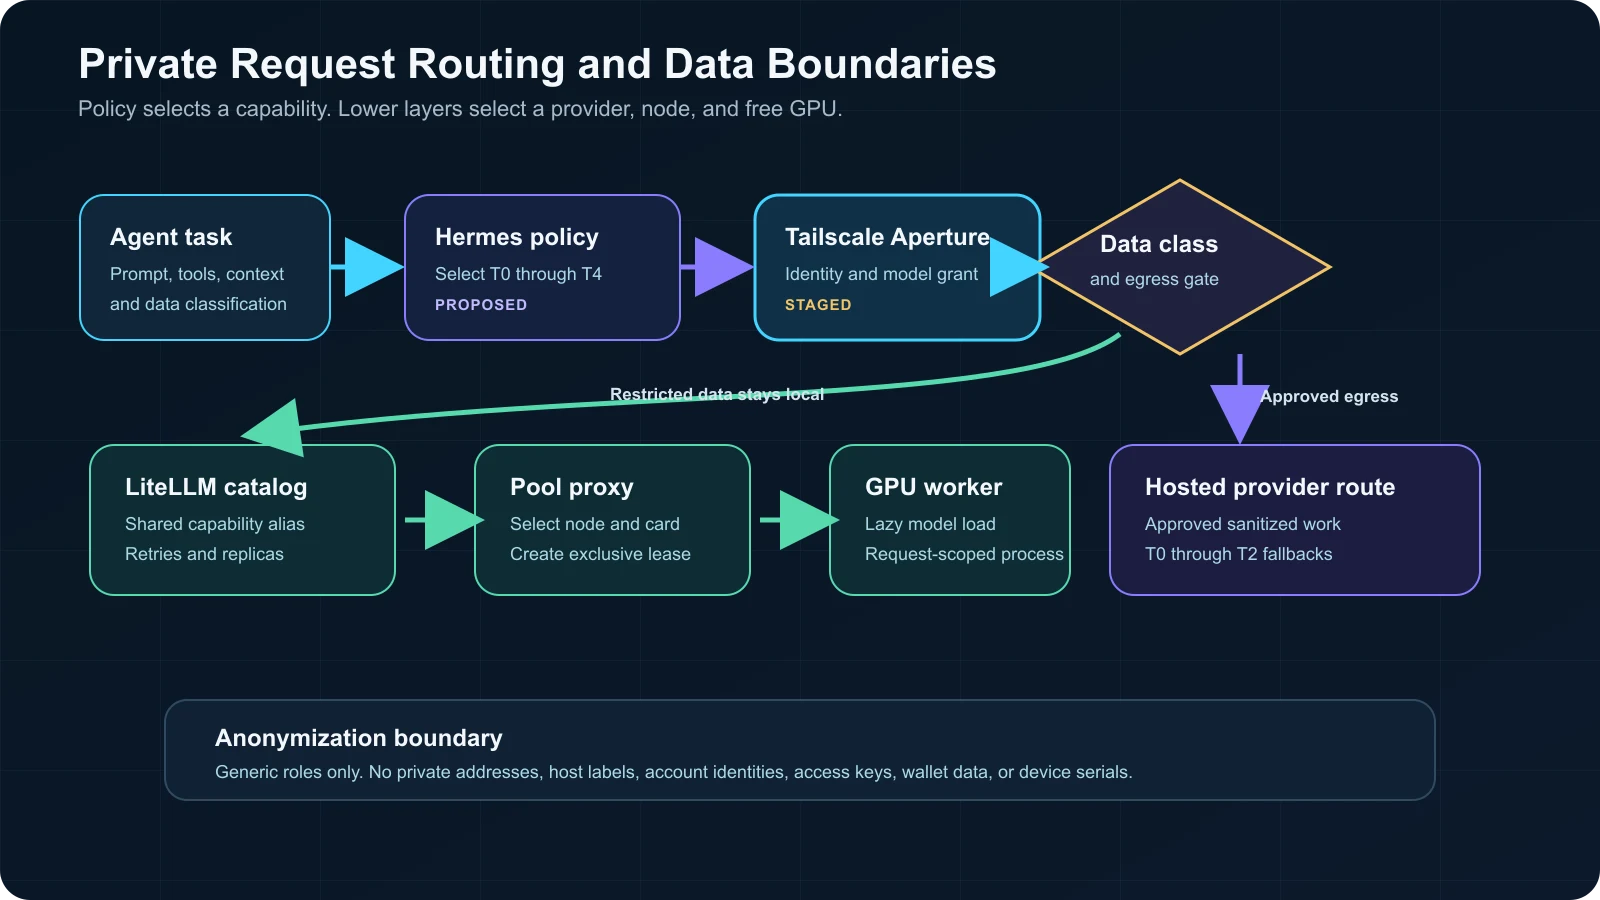
Идентичность, разрешения и класс данных определяют, покинет ли запрос частный парк
LiteLLM представляет единый каталог
На каждом узле инференса работает шлюз LiteLLM. Все шлюзы предоставляют одинаковый логический каталог моделей, даже если модель находится на другом узле. Клиент использует один формат API и один набор псевдонимов.
LiteLLM группирует несколько развертываний под одним именем модели. Затем маршрутизатор выбирает подходящее развертывание и применяет повторы, тайм-ауты, периоды охлаждения или резервирование. Текущая документация маршрутизации LiteLLM описывает общие имена моделей, стратегии маршрутизации и поведение повторных попыток.
В каталоге есть два типа адресов:
| Тип адреса | Пример | Использование |
|---|---|---|
| Общий псевдоним | t4-classify |
Распределять обычную работу между подходящими узлами |
| Псевдоним узла | node-b/qwen-small |
Выполнять диагностику или закреплять размещение |
Общие псевдонимы обеспечивают горизонтальное масштабирование без изменений Hermes. Подходящая новая реплика расширяет группу моделей. Удаление неисправной реплики сужает ее.
Логика жизненного цикла GPU находится ниже LiteLLM. Шлюз остается активным, поскольку его память не резервирует память GPU. Локальный прокси пула получает запрос выбранной модели, выделяет карту, запускает исполнителя и останавливает его после ответа.
Каталог локальных моделей
Парк предпочитает модели размером до 12B параметров. Этот предел соответствует объему памяти видеокарт и оставляет место для контекста и буферов среды выполнения.
Обозначения моделей: B означает миллиард параметров. K означает тысячи настроенных токенов контекста. Квантование снижает числовую точность весов модели, уменьшая расход памяти. Кэш KV хранит состояние внимания для активного контекста и растет вместе с длиной запроса. E4B — обозначение Google для меньшей версии Gemma 4.
| Маршрут уровня | Класс модели | Настроенный контекст | Основная задача | Размещение |
|---|---|---|---|---|
| T3 smart | Qwen3.5 9B, квантованная | 64K | Сложное локальное планирование и общие задачи агента | Узлы GPU с большей памятью |
| T3 code | Granite 4.2 8B, квантованная | 64K | Работа с репозиториями, инструменты, терминал и структурированный вывод | Узлы GPU с большей памятью |
| T3 review | Gemma 4 12B, квантованная | 32K | Независимая проверка и альтернативное рассуждение | Узлы GPU с большей памятью |
| T3 general и vision | Qwen3.5 4B, квантованная | 32K | Масштабируемая общая работа и понимание изображений | Любой совместимый GPU |
| T3 alternative review | Gemma 4 E4B, квантованная | 8K | Разнообразный путь проверки | Любой совместимый GPU |
| T4 code | Granite 4.2 3B, квантованная | 16K | Небольшие правки, вызовы инструментов, структурированный вывод | Любой совместимый GPU |
| T4 classify | Qwen3.5 2B, квантованная | 16K | Классификация, извлечение и переформулирование | Любой совместимый GPU |
| T4 router | Qwen3.5 0.8B, высокоточное квантование | 16K | Намерения, метки, заголовки и короткие преобразования | Любой совместимый GPU |
| T4 embedding | Qwen3 Embedding 0.6B, квантованная | 32K | Память агентов, RAG, поиск по коду и кластеризация | Любой совместимый GPU |
Эти размеры контекста — параметры развертывания, а не заявленные пределы модели. Большое рекламное окно все равно занимает кэш KV и память среды выполнения. Мы выбрали меньшие значения ради стабильной работы на одной карте.
Qwen описывает Qwen3.5 как мультимодальное семейство и публикует малые и большие dense-варианты в коллекции Qwen3.5 . IBM публикует результаты агентного программирования и обработки длинного контекста для Granite 4.2 8B . Google указывает мультимодальный ввод, вызов функций и более длинное заявленное окно для Gemma 4 .
Для эмбеддингов используется отдельная модель, а не чат-модель, у которой запрашивают векторы. В карточке Qwen3 Embedding 0.6B указана длина последовательности 32K, многоязычный поиск, поиск по коду и размерности результата до 1 024.
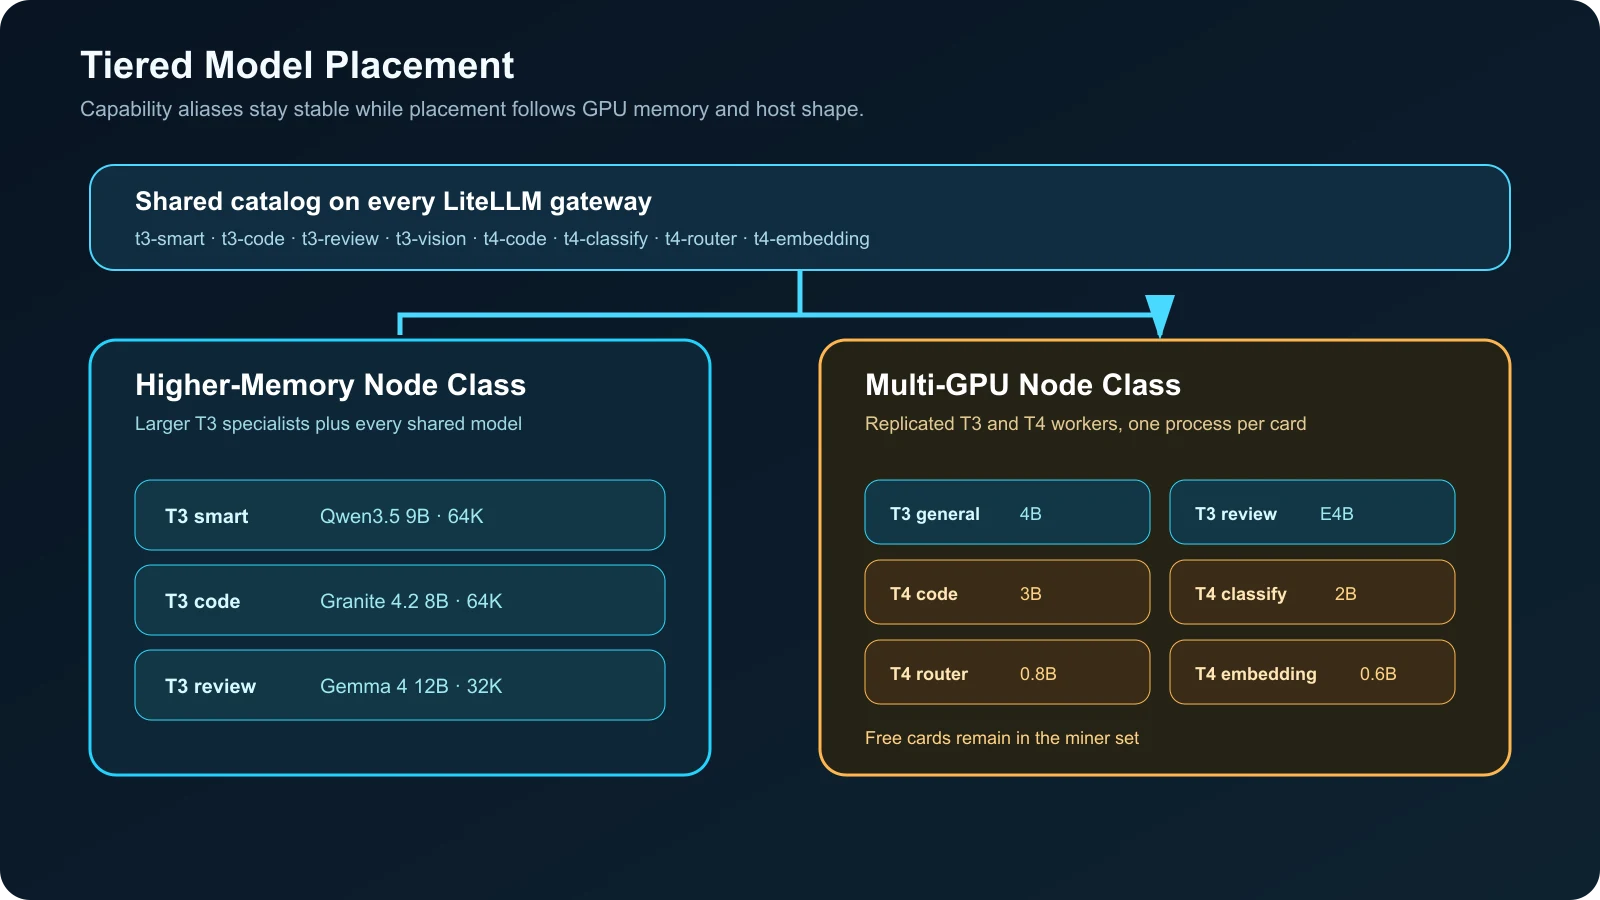
Крупные специализированные модели остаются на картах с большим объемом памяти, малые реплицируются по парку
Почему в производстве используется llama.cpp
llama.cpp соответствует модели ресурсов. Один статический исполнитель привязан к одному GPU, одному файлу модели, настроенному контексту и одной аренде. Граница процесса упрощает аудит запуска, остановки, видимости GPU и журналов.
Сервер предоставляет совместимые с OpenAI интерфейсы чата, ответов и эмбеддингов. Также поддерживаются параллельное декодирование и непрерывная пакетная обработка. В текущей документации мультимодальная поддержка названа экспериментальной. Эти возможности описаны в документации сервера llama.cpp .
Ollama остается путем совместимости на более крупном узле. Когда памяти достаточно, Ollama поддерживает параллельную загрузку моделей и немедленную выгрузку через keep_alive: 0, как описано в
FAQ Ollama
. Мы не выбрали Ollama для производственного пути на каждую карту, поскольку статические исполнители llama.cpp дали более точный контроль размещения и остановки.
Мы также рассмотрели Strata. Strata рассчитана на большую модель Qwen типа mixture-of-experts, распределенную по памяти GPU, системной ОЗУ и накопителю. Опубликованные пресеты начинаются с 32 ГБ общей памяти, а режим low-RAM снижает емкость в обмен на скорость. См. репозиторий Strata . Strata подходит для другой цели: одной более крупной гибридной модели на одной или нескольких картах. Наш парк предпочитает множество независимых исполнителей меньше 12B.
Ленивый запуск на каждой GPU
Ленивая загрузка применяется к каждому исполнителю модели. Между запросами система поддерживает активными только шлюзы, прокси пулов, watchdog и майнер.
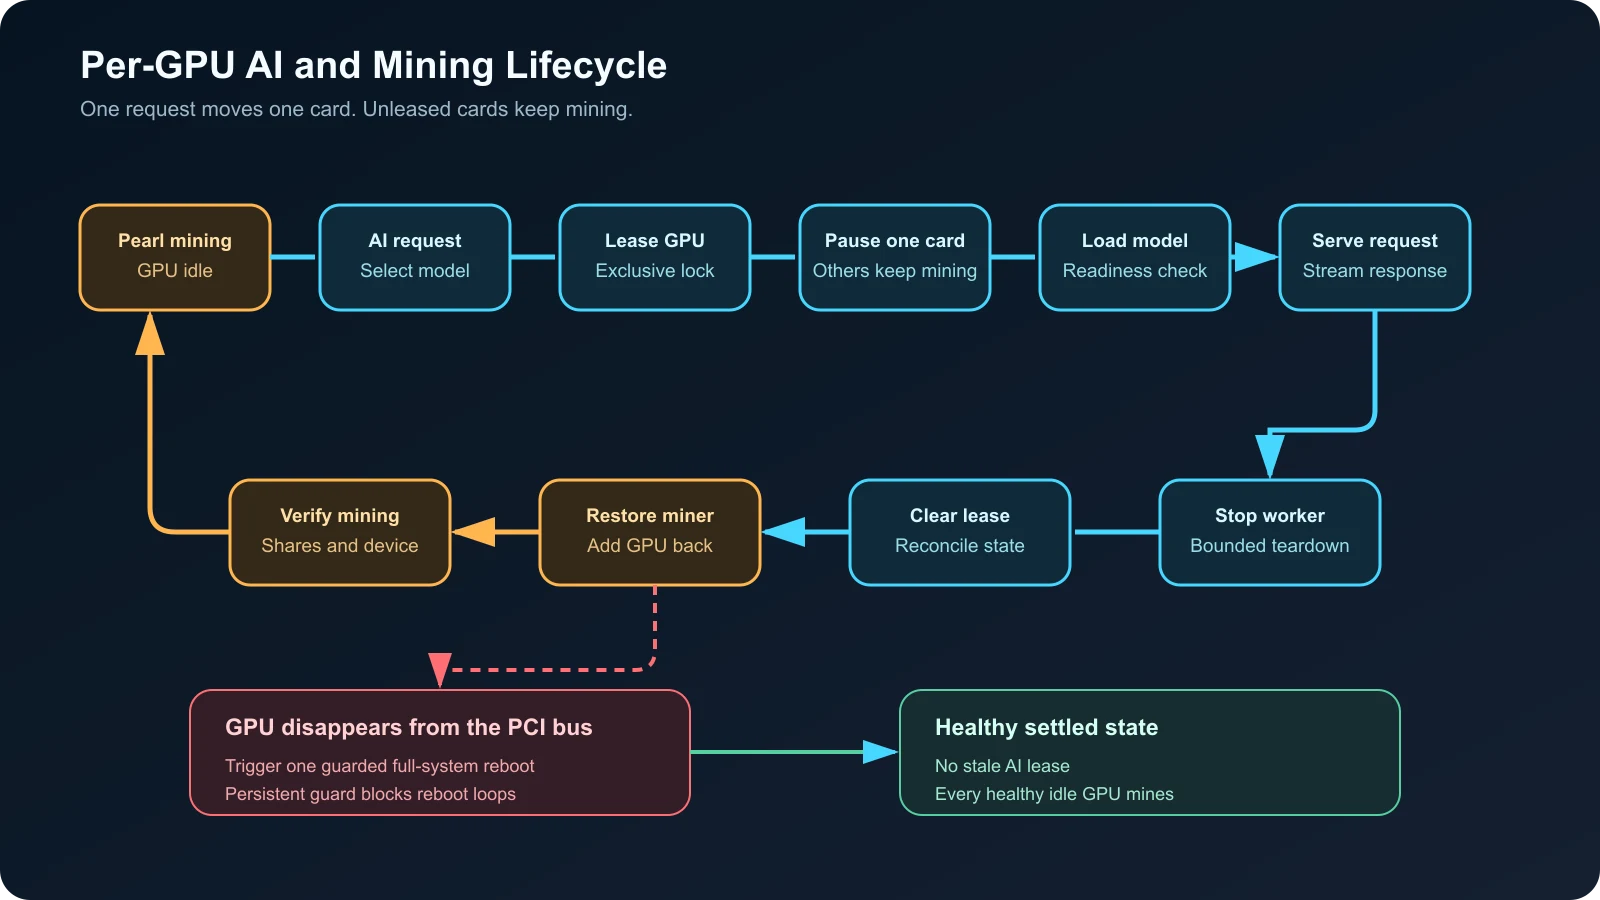
Только арендованная карта покидает майнер и возвращается после завершения процесса модели
Жизненный цикл запроса включает следующие этапы:
- LiteLLM выбирает развертывание. Запрос поступает в прокси пула выбранного класса моделей.
- Пул получает аренду. Блокировка не позволяет двум эксклюзивным исполнителям занять одну карту.
- Майнер перезапускается без одной GPU. Все неарендованные карты остаются в команде Pearl.
- llama.cpp запускается на арендованном устройстве. Проверки готовности завершаются до передачи запроса прокси.
- Исполнитель обрабатывает ответ. Одновременные запросы запускают исполнителей на других свободных картах.
- Исполнитель завершается. Пул удаляет аренду после остановки процесса.
- Майнер перезапускается со свободной GPU. Проверки состояния подтверждают, что карта вернулась к майнингу.
Это не полное переключение всего хоста. Шасси с несколькими картами обслуживает несколько моделей, пока остальные карты продолжают майнить. Простаивающий парк возвращает все исправные GPU к Pearl.
В whitepaper Pearl описана система доказательства матричных вычислений. Архитектура не полагается на прогноз прибыльности или утверждение о финансовой отдаче. Майнинг — настроенная фоновая нагрузка.
Обработка сбоев важнее запуска
Запуск модели — только половина жизненного цикла. Принудительная остановка, исчезновение GPU, прерывание запросов, устаревшие аренды и перезапуски майнера требуют явной обработки.
Watchdog сравнивает настроенный набор GPU с текущим списком устройств NVIDIA. Подтвержденное отсутствие GPU вызывает один защищенный полный перезапуск системы. Безопасный производственный триггер должен требовать повторных неудачных проверок, периода охлаждения, завершения активных задач, постоянного счетчика перезагрузок и удаленного оповещения. Неудачное восстановление должно остановить автоматизацию и потребовать ручного вмешательства.
Тот же watchdog сверяет устаревшие аренды. Если ни один исполнитель не владеет арендой, сверка удаляет старую запись и возвращает GPU майнеру. Этот путь восстановления был важен во время canary-тестирования брокера.
| Сбой | Действие |
|---|---|
| Модель не проходит проверку готовности | Остановить исполнителя, освободить аренду, восстановить майнинг, вернуть ошибку |
| Запрос завершился неожиданно | Ограничить время очистки, завершить дерево процессов исполнителя и сверить аренду |
| GPU исчезла | Подтвердить повторные пропуски, завершить активную работу, запустить один защищенный перезапуск, оповестить и проверить весь настроенный набор GPU |
| Майнер пропускает простаивающую карту | Перестроить список устройств по активным арендам и перезапустить майнер |
| Развертывание LiteLLM отказало | Повторить запрос на другой реплике той же группы, затем применить политику резервирования |
| Grant Aperture блокирует маршрут | Исправить идентификатор или разрешение модели, не обходить политику шлюза |
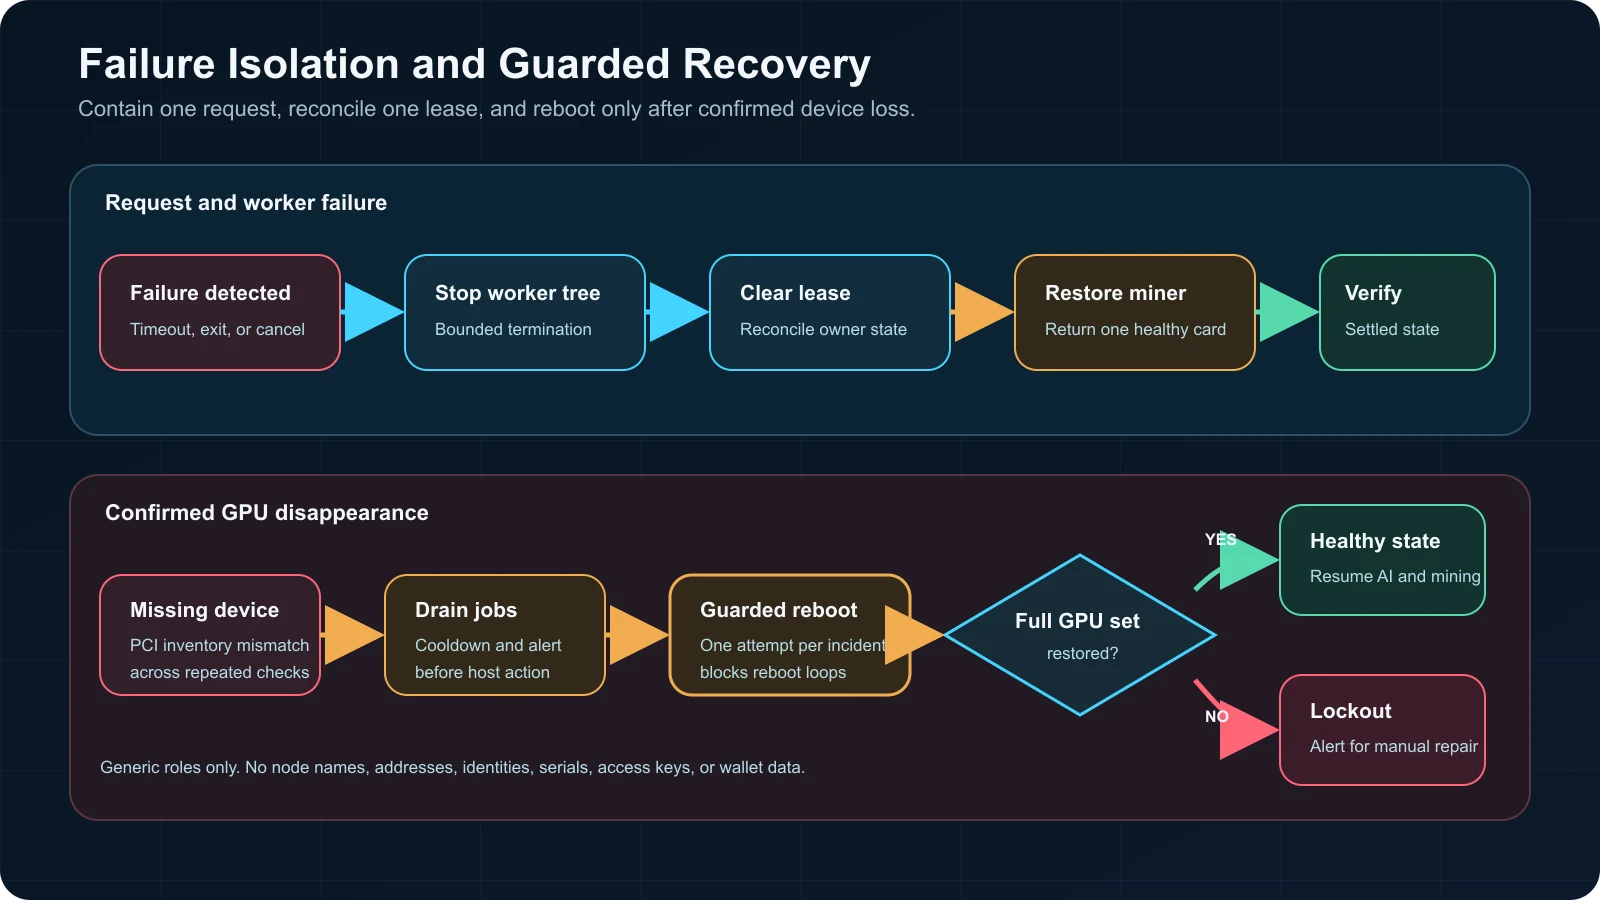
Обычные сбои освобождают одну аренду, а подтвержденная потеря устройства запускает защищенный путь восстановления хоста
Что произошло с экспериментальным брокером
Брокер, независимый от серверной части должен предоставлять один OpenAI-совместимый интерфейс для Ollama, vLLM, llama.cpp и Strata. Он включает управление жизненным циклом каждой модели, выгрузку при простое и размещение на GPU.
21 октября 2026 года мы проверили брокер версии 0.6.0 на коммите c12b65. Локальный набор сообщил о 1 101 успешном тесте и 2 пропущенных, Ruff ошибок не нашел. Затем canary загрузил модель по запросу и успешно обслужил чат-запрос. Остальные GPU продолжали майнить.
Завершение работы выявило критическую проблему жизненного цикла. После загрузки модели брокер застрял на пути остановки, пока systemd не завершил дерево процессов. Принудительная остановка оставила устаревшую аренду GPU до тех пор, пока сверка не восстановила майнер. Мы также обнаружили разрыв между документированной настройкой обязательной GPU и ее применением производственным адаптером.
Мы отключили брокер на производственном пути. Теперь LiteLLM маршрутизирует запросы через прокси пула. Брокер останется экспериментальным, пока интеграционные тесты не подтвердят ограниченную остановку дочерних процессов, завершение групп процессов, проверку допуска обязательных GPU и очистку устаревших аренд.
Это полезный инженерный вывод. Сам факт запуска модели один раз мало что доказывает. Готовность к эксплуатации зависит от корректного завершения, ограниченного восстановления, эксклюзивного допуска устройств и повторяемых учений по сбоям.
Какие проверки мы выполнили
Тест развертывания охватывал не только ответ модели:
- Каждая общая чат-модель прошла цикл загрузки, ответа, завершения и восстановления Pearl хотя бы на одном подходящем хосте.
- Vision приняла изображение через чат-маршрут.
- Эмбеддинги вернули настроенный размер вектора через частный маршрут LiteLLM.
- Несколько моделей одновременно работали на отдельных картах.
- Неарендованные карты оставались у майнера во время параллельных ИИ-запросов.
- Общие псевдонимы маршрутизировали запросы между подходящими узлами.
- Псевдонимы с префиксом узла сохраняли детерминированное размещение.
- Все шлюзы LiteLLM показывали одинаковый логический каталог.
- Отсутствующая GPU восстановилась после полного перезапуска хоста. В watchdog добавлена постоянная защита от циклов.
- Сбой остановки брокера устранился через сверку аренды.
- В итоговом стабильном состоянии не было аренд ИИ, а все исправные GPU вернулись в набор майнера.
Проверки состояния и списки моделей не считались тестами загрузки модели. Полезный приемочный тест отправляет реальный запрос, проверяет ответ, подтверждает выбранную GPU, наблюдает остановку и проверяет возобновление майнинга.
Устранение проблем парка
| Симптом | Первая проверка |
|---|---|
| Модель видна, но запросы завершаются ошибкой | ID upstream-модели, формат API, заголовок авторизации и базовый URL поставщика |
| Aperture возвращает 405 | В корневом URL поставщика нет повторного суффикса /v1 |
| Запрос обслуживается не тем узлом | Общий псевдоним или псевдоним с префиксом узла |
| Два исполнителя выбрали одну карту | Блокировка аренды, ее устаревшее состояние и логика допуска GPU |
| Майнинг остановился на всех картах | Код перезапуска майнера строит список устройств по активным арендам |
| GPU не вернулась к майнингу | Дерево процессов исполнителя, сверка аренды и список устройств майнера |
| Холодная загрузка медленная | Размер модели, скорость накопителя, ширина канала PCIe и загрузка CPU хоста |
| Длинные запросы завершаются ошибкой | Настроенный контекст, запас кэша KV и резерв вывода |
| В Aperture отсутствует маршрут эмбеддингов | Использовать аутентифицированный маршрут LiteLLM с ограничениями по идентификатору Tailscale и межсетевому экрану хоста |
| Остановка брокера зависает | Отключить маршрут брокера и вернуть трафик на проверенный прокси пула |
Полезные правила проектирования
- Маршрутизируйте по цели задачи. Размер модели сам по себе не определяет уровень.
- Держите политику выше размещения. Hermes выбирает псевдоним возможностей. LiteLLM выбирает развертывание. Пул выбирает GPU.
- Считайте каждую GPU отдельной арендой. Переключение всего хоста расходует доступные карты впустую.
- Выгружайте каждую простаивающую модель. Работающим шлюзам не нужны постоянно запущенные GPU-исполнители.
- Сохраняйте ограниченный путь с точным размещением. Псевдонимы узлов только для операторов делают диагностику воспроизводимой.
- Сначала проверяйте завершение. Восстановление майнера и очистка аренды входят в приемочные тесты.
- Разделяйте чат, vision и эмбеддинги. Один шлюз не означает один протокол.
- Убирайте частные сведения из схем. Публикуйте роли и потоки, но не адреса, ключи, идентификаторы и сведения о кошельках.
- Защитите логику перезапуска. Требуйте повторных пропусков, периода охлаждения, постоянного счетчика, оповещения и ручного вмешательства после одного неудачного восстановления.
- Сохраняйте отдельный экспериментальный путь. Сбой брокера не должен затронуть проверенный маршрут.
Следующие шаги
Далее мы оценим нагрузки. Для каждого уровня нужны фиксированный набор задач, критерии приемки, записи о задержке, загрузке GPU, времени простоя майнинга и частоте эскалаций. Эти измерения покажут, какие задачи T2 относятся к T3, а какие задачи T3 подходят для T4.
Мы также планируем провести первый приемочный тест Hermes через Aperture и LiteLLM, а затем повторно проверить брокер после исправления остановки и допуска GPU. Для генерации изображений нужен отдельный адаптер, совместимый с OpenAI и загружающий модели по запросу, прежде чем она войдет в тот же каталог маршрутизации.
Для выбора размера модели прочитайте руководство по локальным моделям ИИ и контексту GPU . О границах конфиденциальности читайте в статье Конфиденциальность и безопасность локального ИИ . Настройку майнера и риски описывает руководство по майнингу Pearl . Не считайте простой GPU гарантированной прибылью.

Related Posts