2x RTX 5060 Ti против GB10: почему 32 ГБ VRAM уступают 128 ГБ объединённой памяти
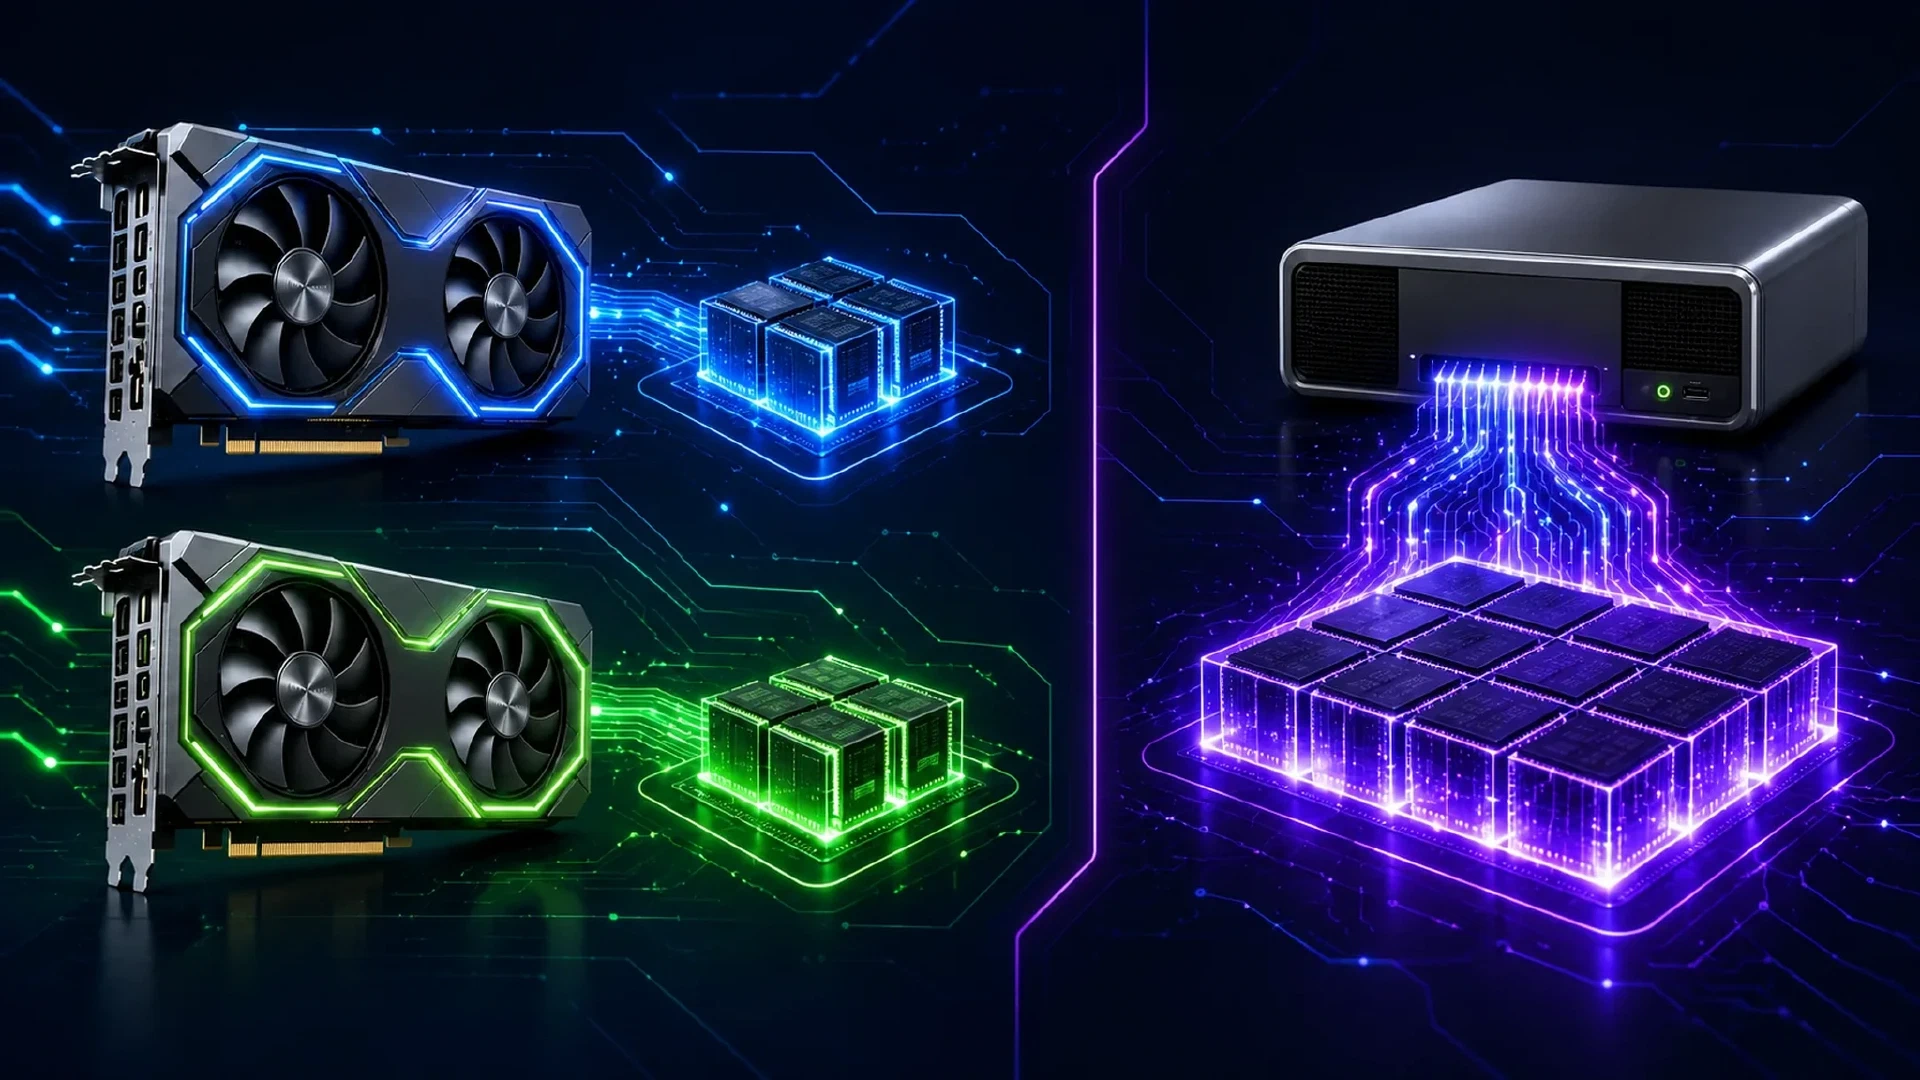
Table of Contents
Две карты RTX 5060 Ti по 16 ГБ выглядят привлекательно в списке комплектующих. Они дают 32 ГБ суммарной VRAM и высокую скорость обработки промпта при коротком контексте. Сравнение меняется при запуске модели 27B с длинным контекстом.
Система NVIDIA GB10 использует 128 ГБ согласованной объединённой памяти. NVIDIA указывает для платформы GB10 128 ГБ объединённой памяти LPDDR5x и TDP чипа 140 Вт. RTX 5060 Ti использует по 16 ГБ GDDR7 на карту, 128-битный интерфейс памяти и общую графическую мощность 180 Вт. Характеристики NVIDIA RTX 5060 Ti и характеристики NVIDIA GB10 ясно показывают разницу в оборудовании.
Суть проста. Две карты по 16 ГБ не создают один быстрый пул памяти на 32 ГБ. Они создают два отдельных пула по 16 ГБ, соединённых через хост-систему. Для вывода большой модели недостающая ёмкость и передача данных между устройствами важнее количества карт.
Сравнение памяти
| Система | Память | Модель памяти | Указанная мощность |
|---|---|---|---|
| 2x RTX 5060 Ti 16 GB | 32 ГБ суммарно | Два отдельных пула памяти GPU | 360 Вт GPU суммарно |
| Система GB10 | 128 ГБ | Согласованная объединённая системная память | TDP GB10 140 Вт |
GB10 выигрывает не потому, что 128 ГБ LPDDR5x совпадают с пропускной способностью мощной дискретной GPU. Преимущество дают ёмкость и размещение. CPU и GPU используют одно адресное пространство, поэтому модель, буферы runtime, активации и данные контекста не обязаны помещаться в двух изолированных устройствах по 16 ГБ.
Перед системой с двумя картами стоит более сложная задача размещения. Модель должна распределиться по обеим картам. Runtime вывода должен перемещать данные между ними. Трафик PCIe добавляет задержку и расходует пропускную способность. Согласно спецификациям NVIDIA, RTX 5060 Ti также не поддерживает NVLink.
Результат бенчмарка
Следующие результаты взяты из предоставленного отчёта по бенчмарку ИИ. В отчёте сравнивается безымянная система dual-GPU с меткой 5060ti-x2 и система GB10. Тест охватывает Qwen и GPT-OSS при разных размерах контекста.
Модели были получены напрямую из Ollama. В тесте использовались буквальные стандартные теги qwen3.8:27b и gpt-oss:latest, без собственного Modelfile и другой квантования. Система 5060ti-x2 использовала PCIe Gen4 x16 и новейшие доступные драйверы NVIDIA для Linux на момент запуска бенчмарка.
Обработка промпта и генерация Qwen
| Контекст | Промпт 5060ti-x2 ток/с | Генерация 5060ti-x2 ток/с | Промпт GB10 ток/с | Генерация GB10 ток/с |
|---|---|---|---|---|
| 4K | 862.5 | 56.9 | 57.4 | 27.7 |
| 16K | 917.3 | 53.5 | 62.1 | 28.1 |
| 32K | 881.4 | 48.8 | 62.4 | 26.9 |
| 64K | 795.1 | 39.6 | 59.9 | 26.1 |
| 128K | 538.7 | 28.3 | 59.9 | 28.6 |
| 256K | 189.9 | 1.2 | 59.9 | 25.8 |
При 4K система с двумя картами генерирует примерно вдвое быстрее GB10. При 64K преимущество сокращается примерно до 1,5 раза. При 128K системы достигают примерно одинаковой скорости генерации.
При 256K сравнение перестаёт выглядеть победой двухкарточной сборки. Запрос 5060ti-x2 достиг только 171 359 фактических токенов промпта. Скорость генерации упала до 1,2 токена в секунду. GB10 завершил полный тест 256K со скоростью 25,8 токена в секунду.
В проверенном результате 256K GB10 генерировал примерно в 21,5 раза быстрее. Важнее другое: GB10 завершил запрошенный контекст. Двухкарточная система не выполнила ту же нагрузку.
Почему суммарная VRAM вводит в заблуждение
1. Модель не видит одну карту на 32 ГБ
Два GPU не объединяют память в одно локальное адресное пространство. Runtime model-parallel распределяет слои или тензоры между устройствами. Каждому устройству всё равно нужно место для назначенных весов, временных буферов и части состояния контекста.
Поэтому доступная ёмкость ниже простой суммы. Точный объём накладных расходов зависит от формата модели, квантования, backend вывода, разбиения тензоров и длины контекста.
2. Память контекста растёт во время генерации
Веса модели составляют только часть бюджета памяти. Key-value cache, или KV cache, хранит данные внимания для предыдущих токенов. Для длинного контекста требуется больше памяти кэша. Тест 4K не предсказывает поведение развёртывания 128K или 256K.
Предоставленные результаты ясно показывают эту границу. Двухкарточная система сохраняет сильное преимущество в обработке промпта, а затем теряет скорость генерации при росте контекста. GB10 держится около 26–29 токенов генерации в секунду от 4K до 256K.
3. Передачи PCIe добавляют цену
Когда runtime перемещает активации или тензоры между GPU, передача проходит через межсоединение хоста. Это создаёт точки синхронизации и добавляет задержку на каждом шаге. Штраф растёт, когда нагрузка постоянно пересекает границу устройств.
Это не делает систему dual-GPU бесполезной. Размещение памяти входит в результат производительности. Бенчмарк, который показывает только обработку промпта при 4K, не учитывает эту стоимость.
4. Энергоэффективность даёт преимущество на уровне системы
В этом сравнении GB10 потребляет меньше энергии и даёт больше памяти для проверенной нагрузки с длинным контекстом. Две карты RTX 5060 Ti имеют общую мощность GPU 360 Вт ещё до учёта остальной системы. NVIDIA указывает TDP GB10 140 Вт.
GB10 меняет пиковую скорость при коротком контексте на ёмкость, завершение задачи и меньшую мощность GPU. Для вывода Qwen с длинным контекстом эти компромиссы важны.
Система 5060ti-x2 стоит намного меньше
Сравнение производительности не отменяет разницу в цене. Полная рабочая станция с двумя RTX 5060 Ti по 16 ГБ была указана по цене $3,479 10 октября 2026 года. В конфигурацию входят Intel Ultra 7 265K, материнская плата Z890, 32 ГБ DDR5, накопитель 1 ТБ, блок питания 1 000 Вт и обе видеокарты. Посмотреть полную конфигурацию dual-GPU .
Американская торговая площадка NVIDIA указывает DGX Spark на 128 ГБ по цене $6,950. В объявлении есть 128 ГБ согласованной объединённой памяти и 4 ТБ NVMe, но система отмечена как отсутствующая на складе. Проверить текущую страницу DGX Spark NVIDIA .
Платформа AMD Ryzen AI Halo Developer Platform даёт ещё одну точку сравнения. Эта система Strix Halo стоит $3,999.99 в Micro Center и имеет 128 ГБ объединённой памяти LPDDR5x и 2 ТБ накопителя. Strix Halo часто относится к тому же практическому классу локального ИИ, что и системы GB10, хотя независимые тесты часто показывают преимущество GB10 в пропускной способности и зрелости ПО. Проверить текущую Linux-страницу Micro Center и прочитать обзор Strix Halo против GB10 .
| Полная система | Цена на 10 октября 2026 года | Разница в цене |
|---|---|---|
| Рабочая станция 5060ti-x2 | $3,479 | Базовая цена |
| AMD Ryzen AI Halo, Strix Halo | $3,999.99 | На $520.99 больше |
| 128 ГБ GB10 DGX Spark | $6,950 | На $3,471 больше |
GB10 даёт больший пул объединённой памяти, меньшее энергопотребление и лучшую архитектуру для длинного контекста. Система AMD предлагает тот же класс памяти 128 ГБ примерно за $4 000. Рабочая станция 5060ti-x2 стоит около 50% указанной цены GB10 до налогов и доставки. Покупатели, которым нужна объединённая память без программного стека NVIDIA, получают более дешёвую альтернативу в Strix Halo.
Это цены разных продавцов, а не контролируемая розничная корзина. В сравнении у 5060ti-x2 также меньше системной памяти и накопителя. Разница важна, поскольку оба объявления описывают полноценные пригодные компьютеры, а не отдельные цены GPU. Текущие предложения RTX 5060 Ti 16 GB находятся около $789–$830 за карту, намного выше стартовой MSRP $429. Преимущество двухкарточной цены сохраняется даже при нынешнем скачке цен на GPU. Текущая проверка цен RTX 5060 Ti .
Результат GPT-OSS требует отдельного рассмотрения
Тот же отчёт показывает хорошие результаты генерации 5060ti-x2 для GPT-OSS от 4K до 256K. GB10 завершает тесты от 4K до 128K, но тест GPT-OSS 256K помечен как unsupported.
Не используйте таблицу GPT-OSS для заявления об универсальном победителе. При 256K тесты не охватывают один и тот же диапазон. Результат Qwen даёт более чистое сравнение длинного контекста, поскольку обе системы сообщают результат 256K, хотя запуск 5060ti-x2 достиг только 171 359 фактических токенов промпта.
Что это значит для сборки Qwen 3 27B
Конфигурация с двумя картами по 16 ГБ способна запустить квантованную модель 27B с меньшим контекстом. Бенчмарк не опровергает такой сценарий. Данные опровергают утверждение, что 32 ГБ суммарной VRAM дают такой же практический запас, как система со 128 ГБ объединённой памяти.
То, что модель помещается на карту, доказывает только ёмкость для весов. Реальная потребность в памяти складывается из весов модели, активного контекста, KV cache, буферов runtime и запаса для операционной системы. Контекст должен помещаться рядом с моделью. Модель, которая загружается, но не оставляет места для рабочей беседы, не является пригодной конфигурацией для длинного контекста.
Это соответствует рекомендациям по расчёту из статьи Достаточно ли 16 ГБ VRAM для серьёзной работы с локальными LLM? , где веса, контекст и выделения runtime рассматриваются как единый бюджет. Руководство по 32 ГБ VRAM для Qwen 27B приходит к тому же выводу для двухкарточных сборок. Суммарная ёмкость не равна доступному запасу.
Перед покупкой оборудования для Qwen 3 27B задайте четыре вопроса:
- Помещается ли нужное квантование вместе с буферами runtime? Одни веса модели не определяют потребность в памяти.
- Помещается ли контекст без сильного давления на KV cache? Длинные промпты меняют результат.
- Использует ли runtime быстрое разделение устройств? Передачи PCIe и размещение тензоров влияют на каждый сгенерированный токен.
- Завершает ли система целевой контекст? Быстрый результат 4K не компенсирует неудачную нагрузку 256K.
Предоставленный тест отвечает на последний вопрос для двухкарточной системы. Запуск достиг 171 359 токенов во время запроса Qwen 256K и генерировал со скоростью 1,2 токена в секунду. GB10 завершил 256K со скоростью 25,8 токена в секунду.
Для этой нагрузки с длинным контекстом объединённая память является лучшей архитектурой, когда альтернатива использует PCIe для размещения рабочего набора модели. PCIe остаётся обходным решением проблемы ёмкости. PCIe не создаёт тот же пул памяти, задержку или путь передачи. Руководство по контексту GPU для локального ИИ объясняет, почему веса модели, KV cache, вывод инструментов и буферы runtime нужно рассчитывать вместе. Бенчмарк GPU Ollama Qwen3.8 27B также показывает, почему результаты длинного контекста требуют отдельного внимания от чисел декодирования короткого контекста.
Вердикт
Две RTX 5060 Ti по 16 ГБ являются плохой заменой GB10, если цель состоит в выводе 27B с длинным контекстом. Они дают более высокую пропускную способность промпта при коротком контексте. Они также потребляют больше мощности GPU и подвергают runtime разделённой схеме памяти.
В предоставленных результатах GB10 медленнее обрабатывает промпт. Система энергоэффективнее, предлагает в четыре раза больше суммарной памяти и завершает полный тест Qwen 256K с пригодной скоростью генерации.
Если вы запускаете короткие промпты и цените загрузку промпта, у 5060ti-x2 есть узкий сценарий применения. Для модели 27B больший пул объединённой памяти является лучшим выбором, поскольку модель и контекст используют единый согласованный рабочий набор. Объединённая память остаётся предпочтительной после появления передач PCIe в пути вывода.
Бенчмарк не показывает, что две RTX 5060 Ti никогда не запускают Qwen 3 27B. Данные показывают, почему запуск модели отличается от качественного выполнения нагрузки.
Ограничения бенчмарка
Предоставленный отчёт указывает буквальные теги Ollama, но не записывает разрешённые digest манифестов, версии моделей, CPU, измерения мощности или конфигурацию охлаждения. Отчёт также указывает PCIe Gen4 x16 для системы 5060ti-x2 и актуальные драйверы NVIDIA для Linux на момент теста. Считайте эти значения наблюдаемым сравнением систем, а не универсальным рейтингом каждой пары RTX 5060 Ti и каждой реализации GB10.
Приведённые выше характеристики оборудования взяты у NVIDIA. Показатели производительности взяты из данных бенчмарка, предоставленных для этой статьи.
Источники
- Библиотека моделей Ollama Qwen3.8
- Теги моделей Ollama GPT-OSS
- Достаточно ли 16 ГБ VRAM для серьёзной работы с локальными LLM?
- 32 ГБ VRAM для Qwen 27B
- Руководство по контексту GPU для локального ИИ
- Бенчмарки GPU Qwen3.8 27B на Vast.ai
- Предложение рабочей станции с двумя RTX 5060 Ti 16 GB
- Предложение NVIDIA DGX Spark на американской торговой площадке
- Linux-предложение AMD Ryzen AI Halo 128 GB
- Обзор Tom’s Hardware: Strix Halo против GB10
- Текущие цены RTX 5060 Ti
Related Posts