Достаточно ли 16 ГБ VRAM для серьёзной работы с локальной LLM?
Table of Contents
16 ГБ выделенной памяти GPU подходят для серьёзной работы с локальной LLM, если модель, контекст и runtime помещаются вместе. Загрузка весов подтверждает только первое требование. Рабочей системе также нужны память для текущего диалога и скорость для завершения задачи.
Используйте Qwen3.8 27B как пример расчёта бюджета для однопользовательского рабочего процесса с кодом или документами. Сначала определите нужный задаче контекст, затем выберите веса и параметры runtime, которые помещаются в оставшуюся память. Спецификации оборудования и источники модели проверены 7 октября 2026 года.
Главное
- Зарезервируйте память под контекст до выбора квантизации.
- Измеряйте обработку промпта отдельно от скорости вывода.
- Отключите неиспользуемую поддержку зрения и протестируйте 8-битный KV-кэш.
- Сравнивайте конкретные GPU, backend, файл модели и длину промпта.
- Рассчитывайте экономию владения по своей нагрузке и счёту провайдера.
Для расчёта нужны журнал памяти runtime, точное имя файла модели и типичная задача. Выделите около 20 минут на настройку и запись результатов, не считая времени инференса. Сложность средняя.
Свяжите память с задачей
16 ГБ подходят нагрузке, в которой веса, активный контекст и временные выделения остаются в доступной памяти GPU. Требуемый контекст зависит от задачи. Краткое резюме документа и агент программирования, читающий десятки файлов, требуют разных бюджетов.
| Нагрузка | Первый вопрос при расчёте |
|---|---|
| Короткий чат или черновик | Достигает ли модель нужного качества? |
| Анализ документов | Помещаются ли исходный текст и ответ вместе? |
| Агент программирования | Сколько контекста занимают файлы и результаты инструментов? |
| Параллельные запросы | Сколько кэша нужно каждой активной сессии? |
Настроенное окно отличается от занятого окна. Бенчмарк с лимитом 64K и коротким промптом не измеряет генерацию после 55K токенов разговора. Перед покупкой оборудования тестируйте длину, близкую к ожидаемой длине сессии.
Почему модель помещается
Квантизация хранит веса с меньшим числом битов. Таблица файлов Qwen3.8 27B от Bartowski указывает 17,44 GB для Q4_K_M. Это уже больше примерно 17,18 млрд байт устройства на 16 GiB до памяти runtime.
Карточка модели GSQ-RCO от ISTA-DASLab указывает 11,8 GB для IQ3_S. Метод назначает разную точность разным тензорам в пределах бюджета размера. Необязательная версия MTP добавляет около 0,35 GB, проектор зрения добавляет около 0,9 GB.
| Опубликованный бенчмарк | Оценка BF16 / IQ3_S |
|---|---|
| AIME25 | 100.00 / 100.00 |
| LiveCodeBench v6 | 85.71 / 85.71 |
| GPQA-Diamond | 89.90 / 89.39 |
Лаборатория называет эту рабочую точку «task-lossless». Эти результаты поддерживают узкое сравнение. Они не доказывают одинаковые ответы, одинаковое извлечение в длинном контексте или одинаковую надёжность в ваших задачах программирования. Проверьте сжатую модель по собственным критериям приёмки.
Посчитайте кэш
KV-кэш хранит ключи и значения внимания для уже обработанных токенов. Промпт, вывод инструментов и сгенерированные ответы расходуют контекст. Некоторые runtime выделяют ёмкость кэша при запуске, поэтому отображаемая память не обязана расти с каждым сообщением.
Конфигурация Qwen указывает 64 слоя, полное внимание в каждом четвёртом слое, четыре KV-головы и размер головы 256. Для этих 16 слоёв полного внимания рассчитанная стоимость кэша FP16 такова:
16 layers × 4 KV heads × 256 elements × 2 (K and V) × 2 bytes
= 65,536 bytes per token
= 64 KiB per token
Расчёт не включает рекуррентное состояние, выравнивание, временные буферы и выделения спекулятивного декодирования. Для других архитектур нужны другие расчёты.
| Занятые токены | Кэш полного внимания FP16 |
|---|---|
| 32,768 | 2 GiB |
| 65,536 | 4 GiB |
| 131,072 | 8 GiB |
| 262,144 | 16 GiB |
Здесь KiB и GiB используют степени 1024. Размеры загрузки моделей используют десятичные GB. Смешивание единиц искажает оставшийся бюджет.
Рассчитайте доступный контекст
Две настройки освобождают память для длинных текстовых сессий: удалите неиспользуемый проектор зрения и снизьте точность кэша. Рассчитайте их эффект относительно загруженной модели и выделений runtime.
Используйте пример ниже, где все выделения выражены в десятичных GB. Резерв 1,0 GB является плановым допущением, а не универсальным значением runtime.
| Выделение | Зрение включено / выключено |
|---|---|
| Физическая ёмкость 16 GiB | 17.180 / 17.180 GB |
| Веса модели | 11.800 / 11.800 GB |
| Необязательная голова MTP | 0.350 / 0.350 GB |
| Оценка проектора зрения | 0.930 / 0 GB |
| Предполагаемые прочие выделения | 1.000 / 1.000 GB |
| Осталось для растущего кэша | 3.100 / 4.030 GB |
При 65 536 байтах на токен 3,100 GB вмещают около 47 300 токенов. При идеальном 8-битном хранении это было бы 32 768 байт на токен и около 123 000 токенов при отключённом зрении.
Реальное хранение q8_0 включает масштабы блоков. При 34 байтах на 32 значения этот пример требует около 34 816 байт на токен, снижая оценку примерно до 115 700. Дополнительные выделения уменьшат результат. Поэтому около 110K является правдоподобным плановым результатом при этих допущениях, а не гарантированной настройкой.
Оставшийся контекст должен включать вход и выход. При окне 65 536 токенов примерный начальный промпт на 30 000 токенов и лимит вывода 8 192 токена оставляют 27 344 токена для файлов, результатов инструментов и диалога. Бюджет начального промпта приведён для примера. Измерьте собственные инструменты и инструкции.
Настройки для тестирования
Документация сервера llama.cpp описывает отдельные типы кэша ключей и значений, автоматическую загрузку проектора и параллельные слоты. Для текстовой нагрузки протестируйте отключённое зрение, q8_0 для обоих типов кэша и один слот. Сначала используйте умеренный контекст.
Запишите выделения перед увеличением контекста. Квантизация кэша требует поддержки выбранной архитектуры и backend. После изменения точности проверьте качество ответа. Сохраните рабочую конфигурацию для сравнения.
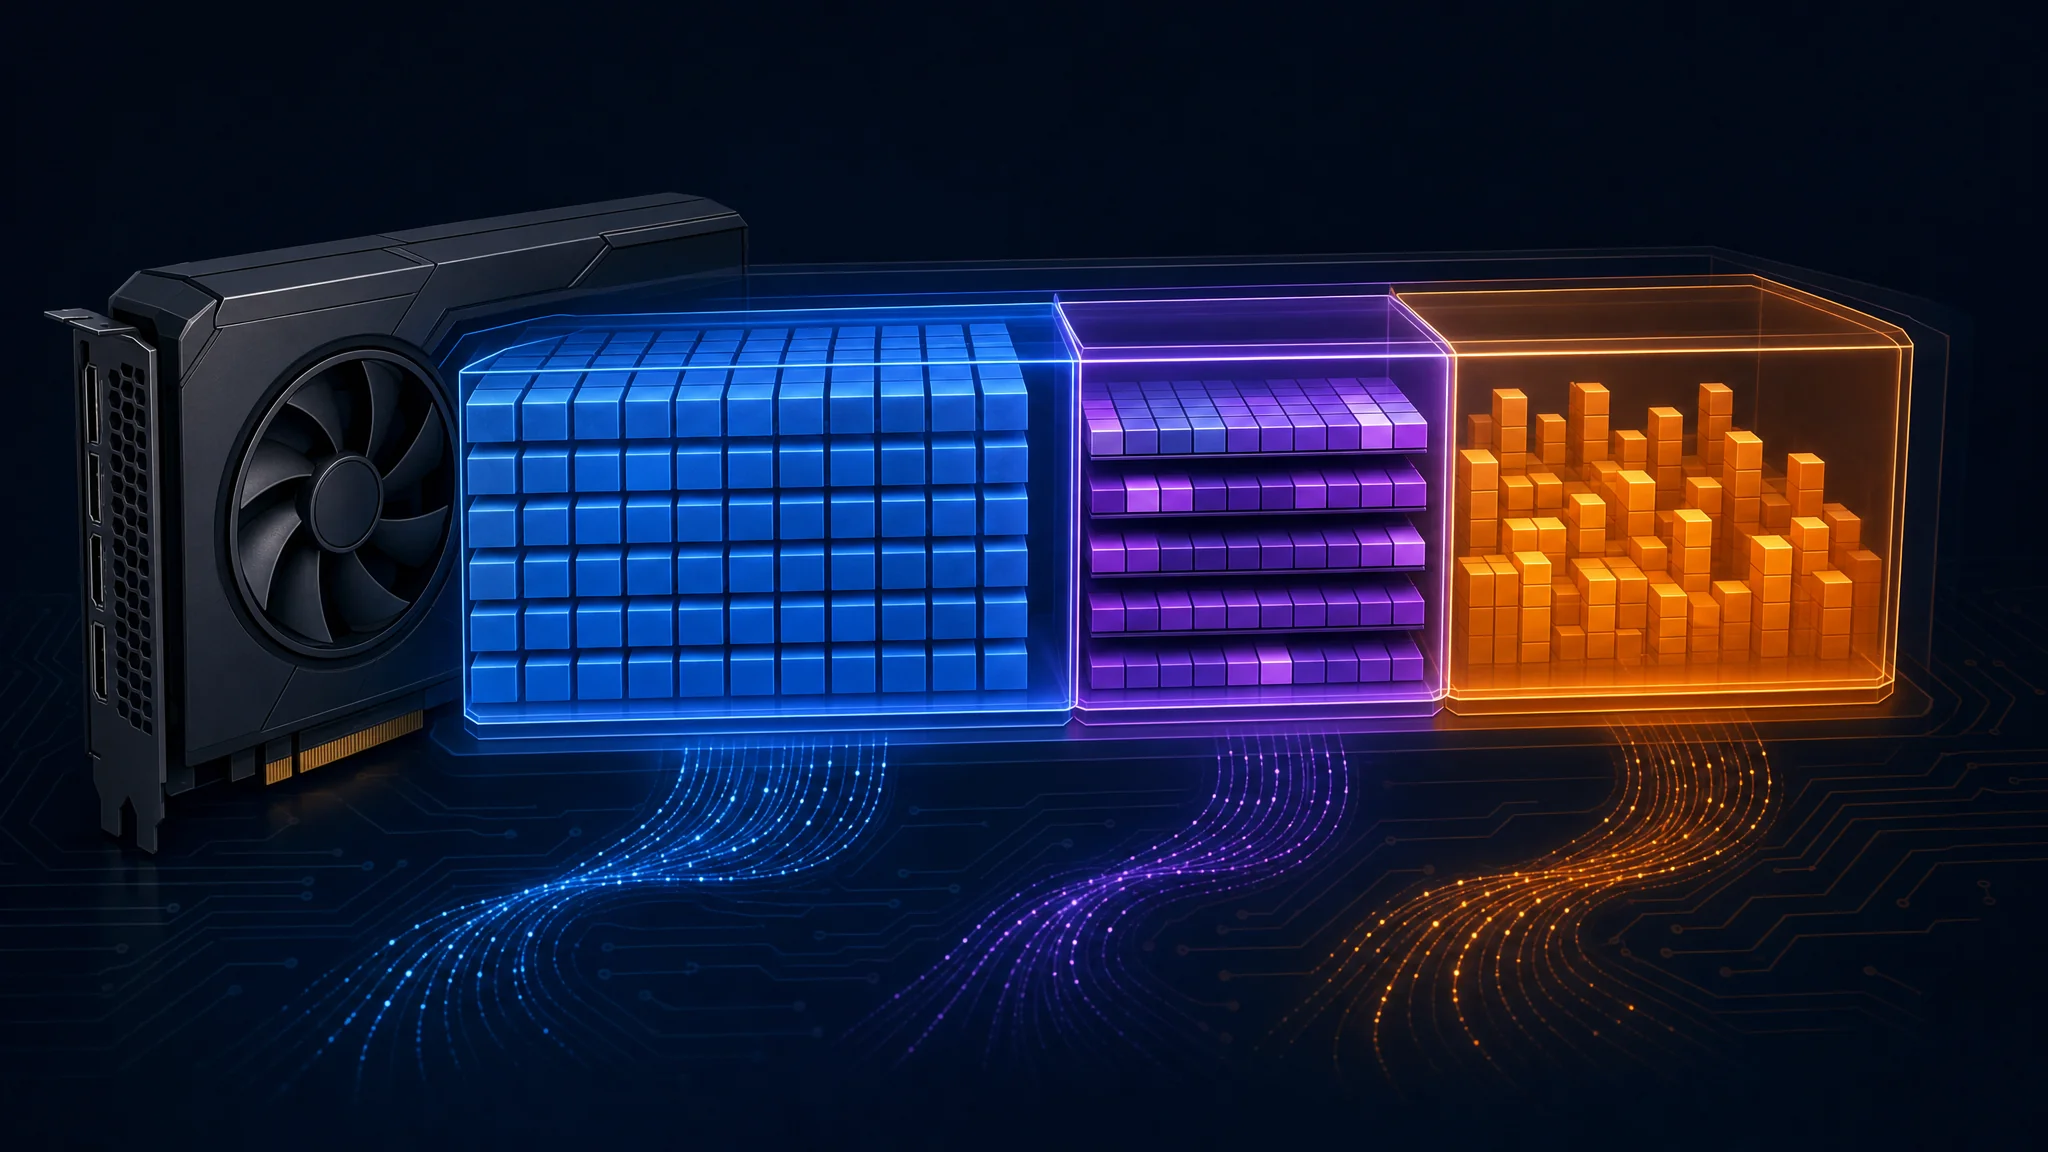
Синий цвет обозначает веса, фиолетовый контекстный кэш, оранжевый выделения runtime. Размеры условны
Почему скорости различаются
Метка 16 GB описывает ёмкость. Производительность также зависит от пропускной способности памяти, вычислительных ядер, активного контекста, offload, batching и спекулятивного декодирования.
| Причина | Что проверить |
|---|---|
| Выгрузка на CPU или RAM | Размещение загруженных слоёв и расположение кэша |
| Длинный контекст | Занятые токены во время измерения |
| Различия backend | Commit runtime, драйвер и путь ядра |
| Спекулятивное декодирование | Принятые черновики и дополнительные выделения |
Для плотной модели, генерирующей по одному токену, деление пропускной способности памяти на объём резидентных весов даёт грубую оценку только по пропускной способности. При 448 GB/s и 11,8 GB весов частное составляет около 38 токенов в секунду. Чтение кэша и вычисления добавляют работу, а спекулятивное декодирование и batching меняют допущения.
Не считайте это частное универсальным верхним пределом. Более высокая скорость вывода не опровергает бенчмарк автоматически. Проверьте, принял ли один проход целевой модели несколько черновых токенов.
Предсказание нескольких токенов, или MTP, требует совместимых модели и runtime. Сравните включённый и выключенный режимы на коротком и длинном занятом контексте. Дополнительные веса и состояние черновика расходуют память, но универсального правила отключать MTP после 32K токенов нет.
Измерьте первый ответ
Prefill обрабатывает промпт до генерации. Decode создаёт ответ. Быстрый decode скрывает медленный первый ответ, когда задача начинается с большого промпта без кэша.
Разделите число некэшированных токенов промпта на измеренную скорость prefill, чтобы оценить время обработки. Для свежего промпта на 30 000 токенов две условные скорости дают такие ожидания:
| Примерная скорость промпта | Расчётное время обработки |
|---|---|
| 750 токенов/с | 40 секунд |
| 150 токенов/с | 200 секунд |
Эти примеры описывают время обработки без загрузки модели и накладных расходов запроса. На измеренную скорость влияют длина промпта, размер пакета, формат модели и backend.
Измерьте отдельно холодный запрос и продолжение с повторно используемым префиксом. Повторное использование префикса не обрабатывает часть повторного ввода. Запишите время до первого токена, скорость decode и общую длительность задачи.
Сравните полные конфигурации GPU
Сравнивайте вместе цену покупки, доступную память, пропускную способность и программный путь. Более дешёвая карта теряет преимущество, если нагрузке нужны неподдерживаемые функции или время превышает целевую задержку.
| Настольная карта 16 GB | Пропускная способность памяти |
|---|---|
| RX 9060 XT | 320 GB/s |
| RTX 5060 Ti | 448 GB/s |
| RX 9070 | 640 GB/s |
| RX 9070 XT | 640 GB/s |
Спецификации AMD RX 9070 и RX 9070 XT подтверждают 16 GB и скорость до 640 GB/s. Сравнение 640 и 448 даёт около 43% большей теоретической пропускной способности. Из этих спецификаций не следует прирост инференса на 43%.
Выбирайте бенчмарки с нужными моделью и backend. Для коротких промптов и устойчивой генерации важнее скорость decode. Для анализа репозитория приоритетом являются холодный prefill, скорость длинного контекста и успешное выполнение задачи. Перед покупкой проверьте доступность программного обеспечения обоих производителей.
Mac и обозначения ноутбуков
Mac на Apple silicon с 16 GB делит память между CPU, GPU, операционной системой и приложениями. Дискретный GPU на 16 GB имеет выделенную видеопамять рядом с системной RAM. Эти объёмы не означают одинаковый бюджет модели.
Apple предоставляет рекомендуемый размер рабочего набора GPU . Проверьте лимит, сообщаемый runtime, и давление на системную память. Оставьте место для macOS и приложений вместо использования всего общего пула для инференса.
Для ноутбуков проверьте точный SKU, выделенную память, лимит мощности GPU и охлаждение. Страница семейства RTX 5060 от NVIDIA перечисляет варианты памяти настольной RTX 5060 Ti. Одно название семейства не подтверждает 16 GB, а результаты настольной карты не подтверждают скорость ноутбука.
Окупается ли владение?
Владение окупается, когда сэкономленные расходы на хостинг превышают эксплуатационные затраты и возвращают цену оборудования. Начните с примера только для вывода: карта за $789, 35 выходных токенов/с, 180 W во время генерации, электричество по $0,18/kWh и $2,95 за миллион размещённых выходных токенов. Это условные значения. Замените их своим предложением, измеренной мощностью, тарифом и ценой провайдера.
Hours per million output tokens = 1,000,000 ÷ 35 ÷ 3,600 = 7.94
Electricity per million = 7.94 × 0.180 kW × $0.18/kWh = $0.257
Savings per million = $2.95 - $0.257 = $2.693
Break-even output = $789 ÷ $2.693 = 293 million tokens
Continuous generation time = 293 × 7.94 ÷ 24 = about 97 days
При восьми часах непрерывной генерации в день тот же расчёт занимает около 291 дня. Восемь часов с открытым ассистентом отличаются от восьми часов генерации токенов.
При цене размещённого вывода $0,16 за миллион локальное электричество в этом сценарии уже дороже хостинга. При этих допущениях положительной окупаемости только по выводу нет.
Используйте текущие цены моделей OpenRouter выбранного провайдера, включая оплату входа и кэшированного входа. Измерьте энергию всей системы, включая prefill. Добавьте обновления, энергию простоя, обслуживание и ожидаемую стоимость перепродажи. Сравнивайте принятую работу, поскольку повторы и различия качества меняют цену задачи.
Когда добавлять память
Переходите за 16 GB, когда измеренная нагрузка превышает доступный контекст при приемлемых качестве и задержке. Длинные ежедневные сессии агентов, параллельные запросы или веса с большей точностью делают больший объём полезным.
Две карты по 16 GB требуют явной поддержки runtime. Они не превращаются в один прозрачный пул на 32 GB. Каждому устройству нужны буферы, а обмен использует межсоединение хоста.
| Стратегия разделения | Главный компромисс |
|---|---|
| Разделение по слоям | Разные слои занимают разные устройства |
| Разделение по тензорам или строкам | Работа внутри слоёв добавляет обмен |
| CPU и GPU | Больше ёмкость с другим профилем задержки |
Вторая карта имеет смысл, если материнская плата, блок питания, охлаждение и backend уже поддерживают план. Сравните полную стоимость системы с одним большим GPU. Руководство по оборудованию Qwen на 32 GB рассматривает эти варианты.
Диагностика и следующие шаги
Если загрузка не удаётся, уменьшите контекст и проверьте выделения. Если скорость падает во время сессии, проверьте занятый контекст и offload на CPU. Если первый ответ задерживается, измерьте холодный prefill. Если использование инструментов ломается после сжатия, сравните ту же задачу с моделью большей точности.
Сохраните повторяемый тест с обычными инструкциями, файлами и выводом инструментов. Запишите ревизию модели, версию runtime, точность кэша, занятый контекст, пиковую память, задержку первого токена, скорость decode и результат задачи. Повторите тест около максимальной ожидаемой длины сессии.
Используйте руководство по локальным моделям и контексту , чтобы сравнить меньшие варианты. Выберите наименьшую модель, отвечающую требованиям качества, затем зарезервируйте память для всей задачи. В этих условиях 16 GB являются полезной целью для рабочей станции.
Related Posts