Маршрутизация провайдеров OpenRouter: качество моделей, лимиты токенов и реальные расходы
Table of Contents
Маршрутизация провайдеров OpenRouter определяет, какой сервис инференса ответит на запрос. Два вызова с одним именем модели всё равно зависят от лимитов endpoint, поддерживаемых параметров, серверного ПО и настроек маршрутизации. Если ответы становятся короче или вызовы инструментов завершаются ошибкой, сначала проверьте эти различия, а не обвиняйте квантизацию.
Главное
- Метки точности описывают числовой формат, а не оценку качества.
- Лимиты endpoint определяют доступный контекст, длину ответа и поддержку функций.
- Явная маршрутизация требует политики резервного перехода и предпочтения провайдера.
- Auto Exacto улучшает выбор провайдера по сигналам качества и предлагает opt-in маршрут для запросов без инструментов.
- Фактическая стоимость включает вывод, поведение кэша, повторы и успешное выполнение задачи.
Требования: Знание JSON-запросов и доступ к конфигурации OpenRouter вашего приложения. Проверка endpoint использует публичный API. Запросы к модели требуют API-ключа и оплачиваются. Перед повторением примера с датой снова проверьте метаданные endpoint.
Время и сложность: Первичная проверка конфигурации занимает около 20 минут. Средний уровень. Полезное сравнение провайдеров требует дополнительных тестов на репрезентативных prompt.
Что скрывает имя модели
Идентификатор модели выбирает нужную модель. Провайдер запускает сервис инференса, включая реализацию модели, лимиты токенов и парсер вызовов инструментов. Бенчмарк модели не проверяет каждый сервис, который размещает эти веса.
| Свойство endpoint | Что проверить |
|---|---|
| Длина контекста | Место для prompt, истории, результатов инструментов и генерации |
| Максимальная длина дополнения | Разрешённый объём ответа для задачи |
| Поддерживаемые параметры | Инструменты, структурированный вывод, sampling и управление рассуждениями |
| Квантизация | Заявленный формат в сравнении с исходным релизом |
| Цена | Ввод, вывод, чтение кэша и дополнительные сборы |
| Поведение сервиса | Качество ответа, ошибки разбора, задержка и повторы |
Базовая маршрутизация выбирает более низкую цену среди исправных кандидатов. OpenRouter описывает взвешивание через обратный квадрат цены. В упрощённом примере кандидат за 1 доллар получает вес выбора в девять раз больше кандидата за 3 доллара. Это относительные веса, а не гарантия следующего запроса. На выбор также влияют заданный порядок, сортировка, кэширование и маршрутизация по качеству. См. документацию по маршрутизации провайдеров .
Взвешивание по цене не доказывает минимальный счёт для вашей нагрузки. В документированном примере не задана универсальная пропорция ввода и вывода для ценового скаляра. Не выводите вероятность выбора провайдера только из цены ввода.
Читайте точность в контексте
Квантизация хранит числовые значения в уменьшенном представлении. Её влияние зависит от модели, метода и реализации инференса. Низкая точность требует тестирования, но сама метка не доказывает изменение исходных весов провайдером.
GPT-OSS даёт конкретный пример. Документация релиза OpenAI для gpt-oss-120b сообщает, что веса экспертов mixture-of-experts используют MXFP4, а оценки выполнялись с той же квантизацией. Метка четырёх битов соответствует опубликованному релизу. Она не доказывает дополнительное ухудшение у провайдера.
Повышение разрядности переводит сохранённые значения в более широкое представление. Преобразование уже квантизованного checkpoint в BF16 не возвращает информацию, потерянную при квантизации. Преобразование исходного checkpoint с большей точностью в четыре бита, напротив, создаёт отдельное изменение, которое нужно оценить.
| Наблюдение | Обоснованный вывод |
|---|---|
| Нативный checkpoint MXFP4 | Четырёхбитные веса экспертов входят в релиз |
| Метка endpoint BF16 | Более широкий заявленный формат без доказательства лучших ответов |
| Неизвестная точность | Нет метаданных, но нет и доказательства скрытой деградации |
| Одинаковые метки точности | Недостаточно доказательств одинакового поведения сервиса |
Одинаковые метки не исключают различия квантизации. Они не показывают, какие тензоры квантизованы, как выполнена калибровка и какие kernels используются. Тестируйте endpoint целиком, а не ранжируйте качество по глубине битов.
Проверьте бюджет токенов
curl --fail --silent --show-error \
  'https://openrouter.ai/api/v1/models/openai/gpt-oss-120b/endpoints' \
  | jq '.data.endpoints[] | {
      name,
      provider_name,
      context_length,
      max_completion_tokens,
      supported_parameters,
      quantization,
      pricing
    }'
API endpoint показывает метаданные провайдеров для одной модели. Команда требует curl и jq. Перед выбором сервиса изучите
текущий ответ endpoint gpt-oss-120b
. Отсутствующие и null-поля считайте неизвестными, а не бесконечными. При сравнении сохраняйте локальный снимок с датой.
Проверка 5 октября 2026 года вернула такие заявленные лимиты gpt-oss-120b. Это метаданные, а не измеренная длина ответа. Провайдеры меняют их со временем.
| Провайдер | Контекстные токены | Максимум токенов дополнения |
|---|---|---|
| DigitalOcean | 128,000 | 4,096 |
| Novita | 131,072 | 32,768 |
| Together | 131,072 | 117,964 |
Длина контекста и длина вывода ограничены отдельно. Модели с длинным контекстом всё равно нужно место для ответа. История, системные инструкции и описания инструментов расходуют место вместе с документом пользователя.
Токены рассуждений также расходуют бюджет генерации в моделях с поддержкой рассуждений. Малый лимит приводит к неполному рассуждению, короткому видимому выводу или завершению до финального ответа. Проверяйте использование и причину завершения, а не связывайте каждый короткий ответ со слабыми весами. OpenRouter объясняет этот бюджет в документации по токенам рассуждений .
Явный max_tokens сообщает маршрутизатору требуемую длину вывода для сопоставления с поддержкой провайдера. Выбирайте значение по измеренным потребностям задачи и доступному контексту. Завышенное значение сужает список кандидатов и не гарантирует более длинный или качественный ответ.
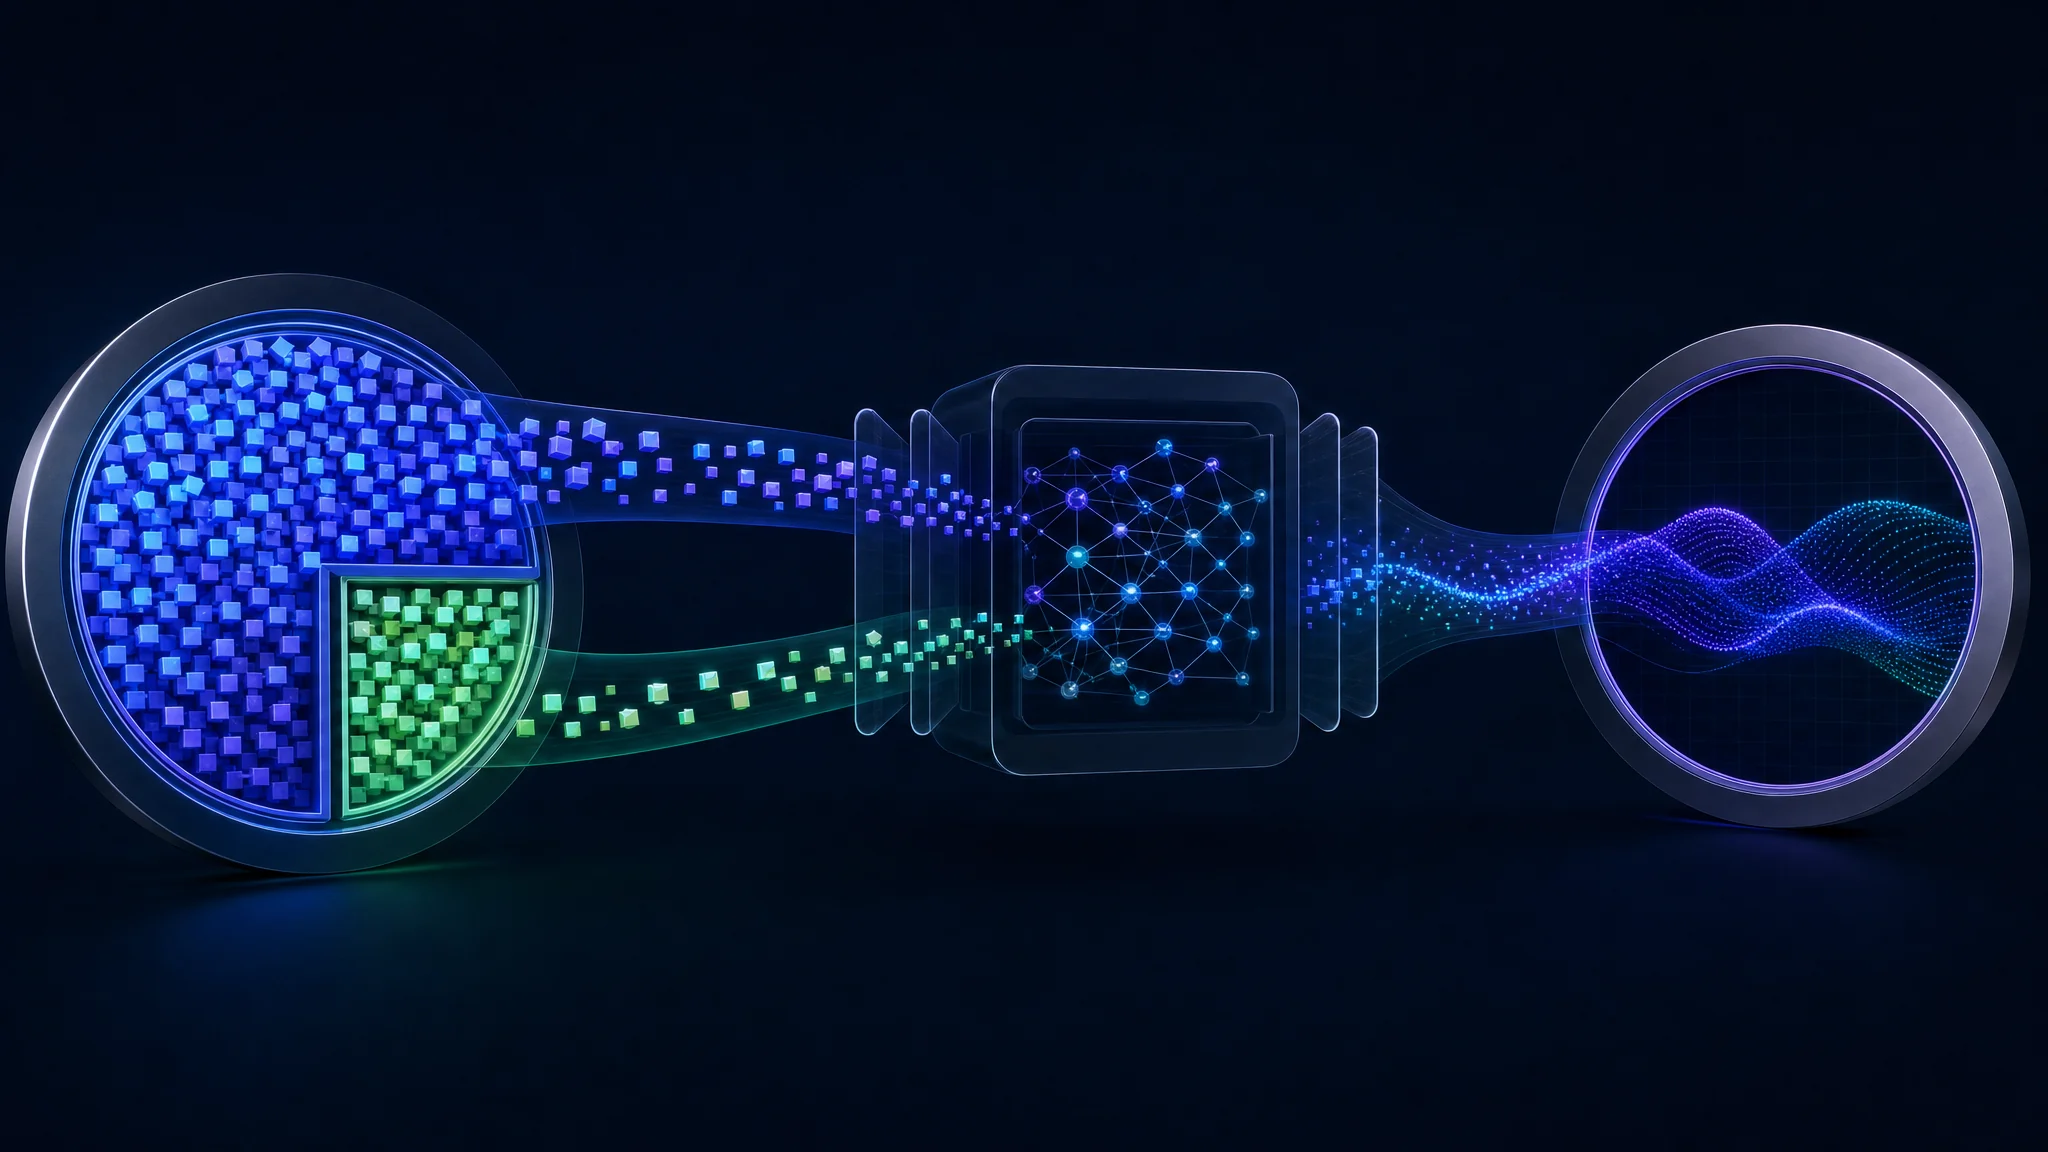
Conceptual token allocation, with reasoning and visible output sharing the completion allowance on supported providers
Требуйте свои параметры
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Explain the failure modes of a retry loop."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
require_parameters по умолчанию имеет значение false. При стандартной маршрутизации неподдерживаемые параметры не обязательно исключают endpoint. OpenRouter описывает провайдеров, игнорирующих неизвестные параметры. Значение true фильтрует маршрутизацию по заявленной поддержке.
Метаданные поддержки не гарантируют поведение. Endpoint с поддержкой seed всё равно требует тестов воспроизводимости. Endpoint с инструментами требует проверки схемы и тестов приложения. Фильтр блокирует известные несовместимости до формирования списка кандидатов.
Закрепляйте провайдеров намеренно
{
  "model": "openai/gpt-oss-120b",
  "messages": [
    {"role": "user", "content": "Summarize the supplied incident report."}
  ],
  "max_tokens": 8192,
  "provider": {
    "order": ["REPLACE_WITH_VERIFIED_PROVIDER_SLUG"],
    "allow_fallbacks": false,
    "require_parameters": true
  }
}
Замените placeholder slug провайдера, скопированным из списка провайдеров модели. Передайте отчёт в реальном запросе. Это шаблон для проверки конфигурации, а не готовый запрос, пока placeholder не заменён.
order задаёт предпочтение. Само поле оставляет fallback к другим провайдерам. Связка с allow_fallbacks: false ограничивает маршрутизацию перечисленными провайдерами. Если ни один не удовлетворяет запросу или недоступен, запрос завершится ошибкой.
Варианты endpoint требуют внимания. Базовый slug провайдера соответствует нескольким вариантам по документированным правилам. При тестировании конкретной конфигурации используйте slug нужного варианта. Проверяйте указанного провайдера в каждом ответе.
quantizations представляет список разрешённых названных форматов, а не числовой минимум. Массив с "fp8" выбирает подходящие FP8 endpoint. Он автоматически не включает BF16 и все форматы с большим числом битов. Сначала сравните исходный checkpoint, затем применяйте фильтр только при наличии оснований.
Не отключайте маршрутизацию качества
{
  "model": "openai/gpt-oss-120b:exacto",
  "messages": [
    {"role": "user", "content": "Compare the two supplied incident reports."}
  ],
  "max_tokens": 8192,
  "provider": {
    "require_parameters": true
  }
}
Auto Exacto использует пропускную способность, телеметрию вызовов инструментов и бенчмарки, чтобы понизить приоритет слабых провайдеров. В объявлении OpenRouter за март 2026 года сообщается о снижении ошибок вызовов инструментов GLM-5 на 88%, примерно с 8% до 1%. Для gpt-oss-120b сообщается снижение с 5,6% до 3,5%.
Это результаты, заявленные провайдером, а не обещание для вашего приложения. Проверка вызова оценивает JSON, имена и схемы. Синтаксически правильному вызову всё ещё нужны верные аргументы и действие для задачи пользователя.
Запросы с инструментами получают Auto Exacto по умолчанию, если у модели достаточно провайдеров. Для остальных запросов :exacto включает маршрутизацию качества. Текущая документация поддерживает её для суммирования и чата, а также для инструментов.
sort: "price", суффикс :floor и сортировка по цене на уровне аккаунта отключают Auto Exacto. Проверяйте настройки приложения и аккаунта вместе. Перед сочетанием параметров маршрутизации изучите
документацию Auto Exacto
.
Рассчитайте стоимость нагрузки
Одной цены входа недостаточно для сравнения. Ниже приведены условные ставки в долларах за миллион токенов. Они показывают арифметику, а не текущие расценки провайдеров.
| Условный endpoint | Цена входа | Цена выхода |
|---|---|---|
| A | $0.03 | $16.00 |
| B | $0.42 | $1.32 |
Workload: 6 million input tokens + 1 million output tokens

A = 6 × $0.03 + 1 × $16.00 = $16.18
B = 6 × $0.42 + 1 × $1.32  =  $3.84

Per million combined input and output tokens:
A = $16.18 / 7 = $2.31
B =  $3.84 / 7 = $0.55
Endpoint A стоит примерно в 4,2 раза дороже для этой смеси, несмотря на низкую цену входа. Соотношение цены выхода к входу 533 к 1 для A сравнивает две ставки, но не является множителем общей стоимости. Другие пропорции входа и выхода изменят сравнение.
Единицы цены API отличаются от таблиц. API endpoint выражает стоимость за токен. Умножьте её на миллион перед сравнением с приведёнными ставками.
Кэширование prompt добавляет ещё одну переменную. Чтение кэша, запись кэша и некэшированный ввод нужно учитывать отдельно по правилам провайдера. Повторяющийся текст не гарантирует попадание в кэш. Проверяйте количество кэшированных токенов и стоимость в документации кэширования prompt .
Маршрутизация влияет на непрерывность кэша. OpenRouter описывает sticky routing для кэширования, а ручной порядок провайдеров имеет приоритет. Auto Exacto также меняет порядок и иногда прерывает тёплый кэш. Перед изменением политики сравните экономию кэша с качеством и стоимостью повторов.
Стоимость принятого результата полезна для приложения. Разделите все расходы, включая повторы и неудачные попытки, на результаты, которые соответствуют критериям приёмки. Дополнительные нетокенные сборы учитывайте отдельно. Низкая цена токенов не компенсирует повторяющиеся неудачи.
Диагностируйте нестабильный ответ
| Симптом | Первая проверка |
|---|---|
| Короткий или незавершённый ответ | Причина завершения, лимит вывода, использование рассуждений |
| Нет деталей документа | Отправленное содержимое, лимит контекста, обрезка клиентом |
| Неправильный вызов инструмента | Заявленная поддержка, схема инструмента, поведение парсера |
| Другое поведение sampling | Запрошенные параметры и заявленная поддержка |
| Неожиданные расходы | Объём вывода, чтения кэша, повторы, смена провайдера |
| Нет подходящего провайдера | Конфликтующие лимиты, allowlist и ограничения fallback |
Сохраняйте ID генерации из ответа. API метаданных генерации OpenRouter показывает провайдера, использование, стоимость и сведения о завершении. ID сессии группирует связанную работу, но не заменяет ID генерации для поиска одного запроса.
Сохраняйте запрос рядом с ID генерации. Записывайте модель, предпочтения провайдера, параметры, время и использование ответа. Так последующее сравнение качества или стоимости останется воспроизводимым после изменения маршрутизации, цен или метаданных endpoint.
Сравнивайте endpoint в одинаковых условиях. Используйте один prompt, инструменты, настройки рассуждений и бюджет токенов. Повторите тесты на нескольких типичных задачах. Отдельно учитывайте неполные ответы, неправильные вызовы и неверные ответы.
Неопределённость бенчмарка важна. Анализ Epoch AI о том, почему бенчмаркинг сложен , описывает влияние реализаций, sampling и каркасов агентов. Один плохой ответ не доказывает постоянный дефект провайдера и не устанавливает его причину.
Практика маршрутизации endpoint
Дополнительное видео: Обсуждение качества и маршрутизации endpoint OpenRouter . Перед применением конкретных цен, лимитов или сравнений снова проверьте список endpoint.
Следующие шаги
- Изучите endpoint одной модели и запишите лимиты, важные для вашей нагрузки.
- Выберите политику маршрутизации с явными требованиями параметров и поведением fallback.
- Проверьте типичные задачи на кандидатах и при маршрутизации качества.
- Записывайте стоимость принятого результата вместе с задержкой, использованием кэша и категориями ошибок.
- Повторяйте проверку после изменений версии модели, поведения сервиса или цен провайдера.
Для общих основ ИИ продолжите с материалом Основные понятия ИИ . О разрешениях агентов и контролях проверки читайте в Защита систем ИИ .
Related Posts