Локальное программирование с ИИ на GPU 16 ГБ: Strata, OpenCode и Qwen3.8
Table of Contents
Локальный агент программирования на GPU 16 ГБ подходит для ограниченных задач разработки. Strata и OpenCode объединяют локальный вывод, редактирование файлов, команды оболочки и запуск тестов. В заявленном запуске Qwen3.8-Flash-Next на RTX 4060 Ti были завершены приложение, последующие изменения и прототип гоночной игры без платных вызовов вывода.
Замена подписки требует более широкого теста. Опубликованные результаты показывают рабочую конфигурацию на одной машине. Они не доказывают равенство платным сервисам программирования для разных языков, репозиториев или сложных задач отладки. В оборудовании также есть 64 ГБ системной оперативной памяти, где хранится значительная часть модели.
Главное
- 16 ГБ означает память GPU, а не общий объём памяти для заявленной конфигурации.
- Повторное использование промпта важно, поскольку агенты программирования многократно отправляют перекрывающуюся историю диалога.
- Рассуждениям нужен бюджет, чтобы планирование оставляло место для кода и вызовов инструментов.
- Успешные сгенерированные тесты дают частичное подтверждение, а Docker и игровой процесс требуют отдельных проверок.
- Нулевые расходы на API не включают стоимость владения, электричество и время обслуживания.
Требования: Совместимый компьютер, свободное место для выбранной модели, Git, Node.js с npm и знакомство с терминальными инструментами. Для конфигурации IQ3_S используйте 64 ГБ ОЗУ. Чтобы проверить другие конфигурации, используйте текущий установщик Strata.
Время и сложность: Средний уровень. Учтите время загрузки большой модели и установки до оценки скорости выполнения задачи. Заявленные сроки не включают настройку.
Тестовая конфигурация
| Компонент | Заявленная конфигурация |
|---|---|
| GPU | NVIDIA RTX 4060 Ti, 16 ГБ VRAM |
| CPU | Intel Core i5-11600K |
| Системная память | 64 ГБ ОЗУ |
| Накопитель | NVMe SSD |
| Модель | Qwen3.8-Flash-Next, 125B MoE, IQ3_S |
| Движок вывода | Strata |
| Агент программирования | OpenCode |
| Настроенный контекст | 65 536 токенов |
| Настроенный лимит вывода | 16 384 токена |
Опубликованные NetworkCoder конфигурация и результаты дают эти значения. Тестовый репозиторий сообщает о загрузке 46,84 GiB весов экспертов за 28 секунд. 4 431 эксперт занимал 8,45 GiB памяти GPU. Эти измерения описывают проверенный запуск, а не гарантированное распределение в другой версии движка.
Текущая совместимость шире этого теста. По состоянию на 6 октября 2026 года проект Strata описывает некоторые карты NVIDIA и AMD минимум с 12 ГБ VRAM, а также меньшие модели для систем с 32 ГБ ОЗУ. Эти варианты не воспроизводят эксперимент с GPU 16 ГБ, ОЗУ 64 ГБ и IQ3_S. Перед покупкой оборудования проверьте точную модель GPU, вариант модели и поддержку среды выполнения.
Где находится модель
Смесь экспертов, или MoE, активирует для каждого токена часть экспертных сетей модели. Это сокращает активные вычисления по сравнению с использованием всех параметров на каждом шаге. Остальным весам всё равно нужны хранилище и путь к вычислениям.
Гибридное выполнение Strata держит часто используемых экспертов на GPU, а коллекцию экспертов сохраняет в системной памяти. CPU вычисляет экспертов без кэша на месте, а GPU обрабатывает экспертов из кэша. В хранилище также находятся файлы модели и данные поиска. Система не помещает всю модель 125B в 16 ГБ VRAM.
У памяти GPU есть конкурирующие задачи. Выделения среды выполнения, состояние внимания и кэш экспертов делят ограниченный ресурс. Большее место для контекста уменьшает оставшуюся ёмкость кэша экспертов. Актуальные версии Strata поддерживают потоковую передачу KV-кэша, поэтому точное размещение отличается от старой конфигурации. Обратитесь к технической документации для вашей версии движка.
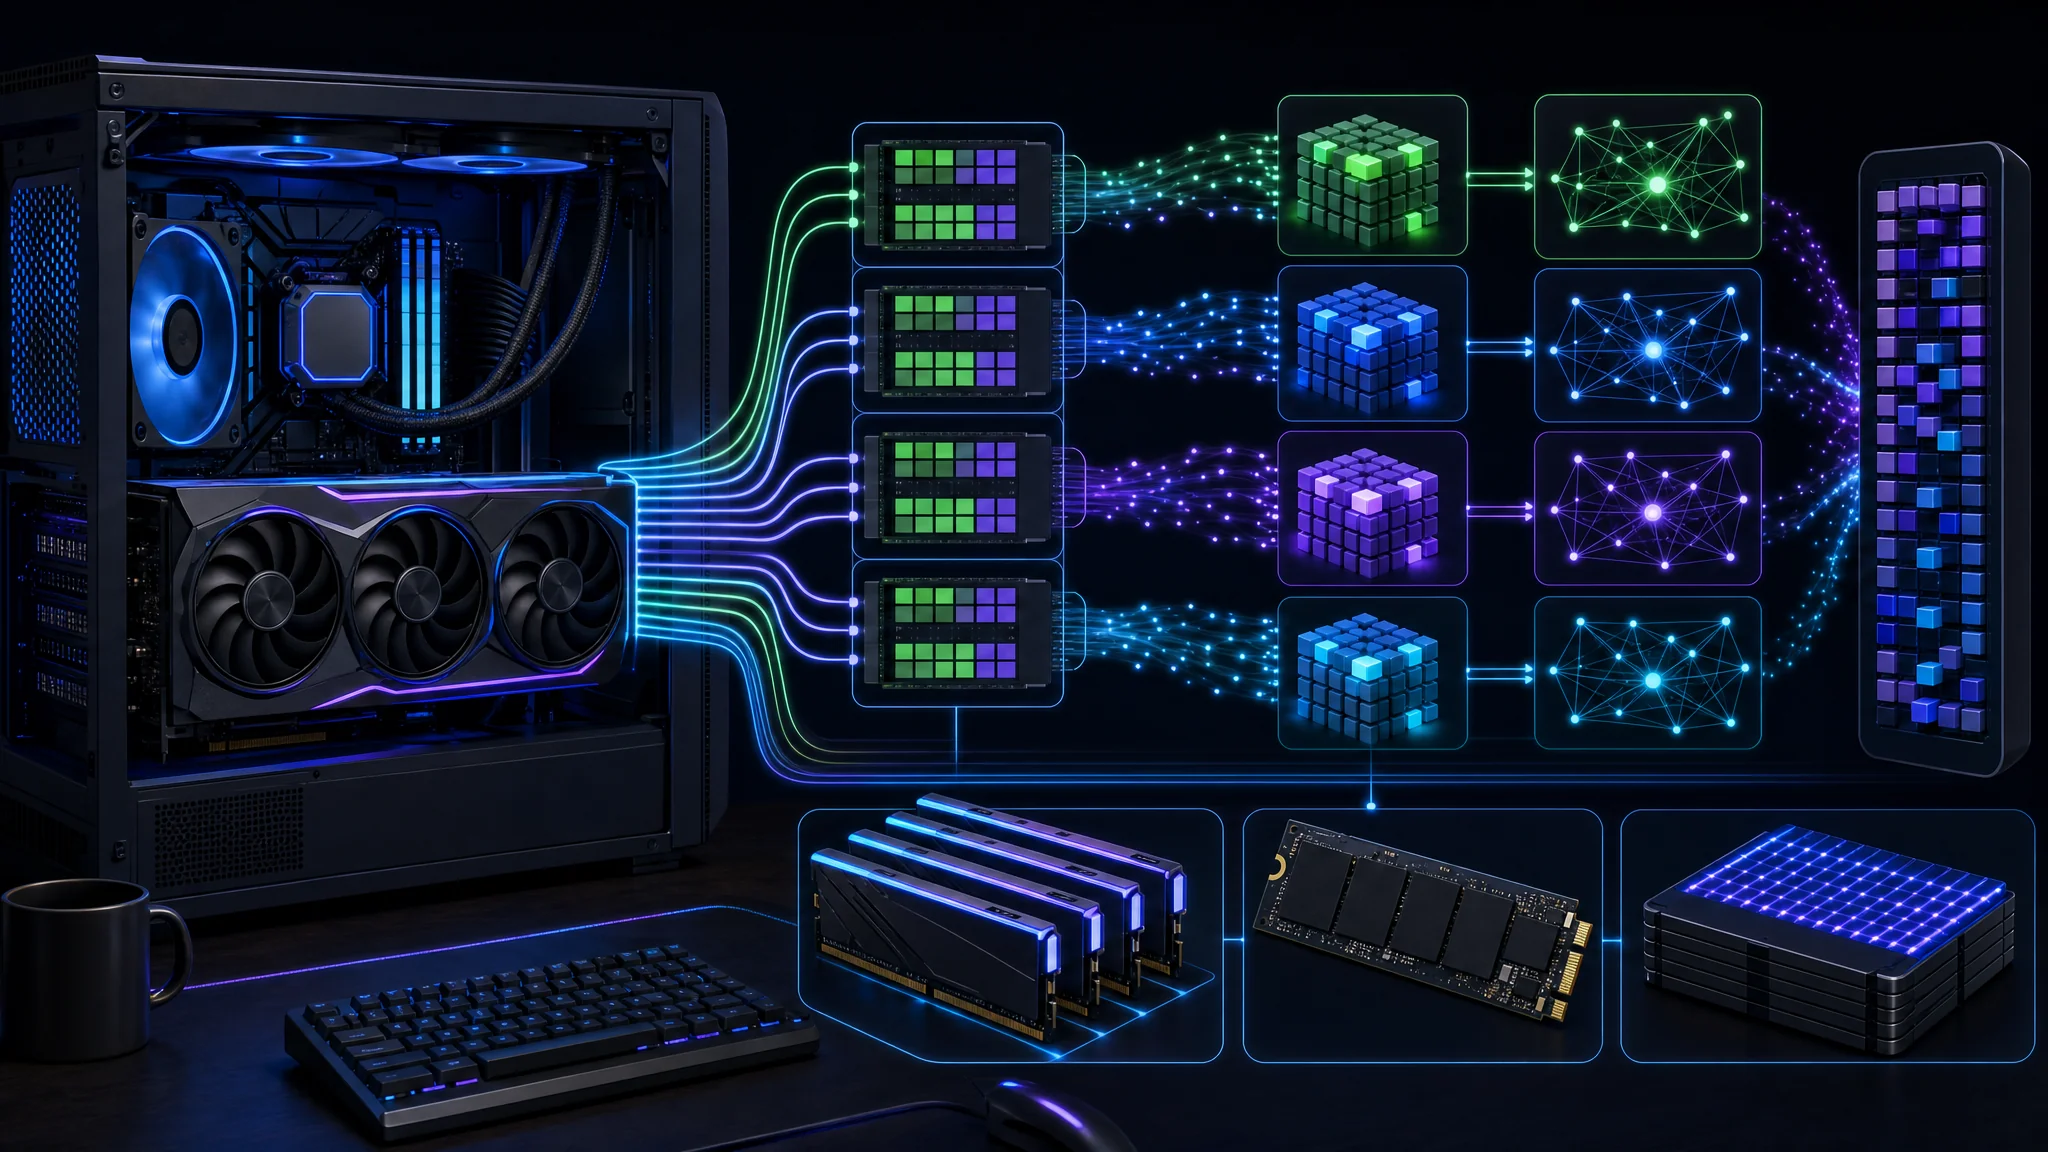
GPU является одной частью системы вывода наряду с вычислениями CPU, системной ОЗУ и хранилищем
Повторное использование промпта меняет скорость
Агент программирования работает в цикле: читает задачу, запрашивает действие инструмента, получает результат и выбирает следующее действие. Содержимое файлов, ошибки и результаты тестов накапливаются в диалоге. Агенты также сжимают или выбирают контекст, поэтому не каждая реализация бесконечно отправляет неизменённую полную историю.
Prefill обрабатывает входные токены до генерации. Decode создаёт ответ. Система с быстрым decode, но медленным повторным prefill всё равно заставляет ждать между вызовами инструментов.
В заявленном измерении для 44 тысяч токенов использовалось повторное использование префикса. Strata повторно использовала уже обработанное содержимое диалога, а растущий промпт был готов примерно за одну-три секунды. Это полезное свидетельство для продолжающейся сессии агента. Оно не доказывает обработку 44 000 полностью новых токенов с нуля за одну секунду.
| Измерение | Что записать |
|---|---|
| Холодный промпт | Время для нового содержимого без повторно используемого состояния префикса |
| Тёплое продолжение | Время после добавления результата инструмента к существующему контексту |
| Скорость генерации | Токены в секунду во время ответа |
| Длительность задачи | Планирование, генерация, инструменты, тесты и повторы вместе |
Два кэша служат разным целям. Кэш экспертов держит часто используемые веса рядом с вычислениями GPU. Повторное использование префикса не даёт повторять работу над прежним вводом. Высокая доля попаданий в кэш экспертов не доказывает попадание в кэш промпта.
Что показали задачи
| Задача | Заявленное время | Заявленный результат |
|---|---|---|
| Создание менеджера задач | 3 мин 38 с | Express API, интерфейс, тесты 5/5 |
| Исправление редактирования и добавление дат | 4 мин 58 с | Изменения завершены, тесты 6/6 |
| Добавление экспорта, импорта и упаковки | 3 мин 48 с | Тесты 7/7, сборка Docker не проверена |
| Гоночная игра, первая попытка | 6 мин 35 с | Вывод исчерпан во время рассуждений, кода нет |
| Гоночная игра, повтор с бюджетом | 4 мин 51 с | Игра создана, синтаксис JavaScript проверен |
Опубликованный файл результатов фиксирует скорость вывода 48–52 токена в секунду для первой задачи, 40–43 для второй и 37–44 для третьей. «До 52» означает пик среди этих наблюдений, а не постоянную скорость для каждой задачи.
Первые три задачи расширяют одно приложение. Значения 5/5, 6/6 и 7/7 описывают последовательные наборы тестов. Их сумма не доказывает 18 независимых возможностей. Тесты, написанные тем же агентом, также требуют проверки покрытия и содержательных утверждений.
Восстановление среды было частью работы. Агент восстановился после неподходящей команды оболочки и обнаружил устаревший сервер приложения во время тестирования. Это полезное поведение, хотя завершение существующего процесса требует осознанных разрешений в общей среде разработки.
Docker остался непроверенным. Агент написал Dockerfile, но для сборки у него не было работающего движка Docker. Успешные тесты приложения вне контейнера не доказывают рабочий образ. Повторная попытка с игрой также проверила синтаксис и открыла браузер, но прямого визуального подтверждения игрового процесса у агента не было.
Оставьте место для вывода
{
  "reasoning_budget_tokens": 8000
}
Объедините эту настройку с существующей конфигурацией strata-iq3_s.json, сохранив остальные поля, затем перезапустите выбранную модель Strata. Это настройка Strata, а не замена конфигурационного файла OpenCode. Проверьте активный бюджет в выводе запуска.
Strata описывает жёсткий бюджет рассуждений, который завершает фазу размышления и переходит к ответу. Значение на уровне запроса заменяет настроенное значение по умолчанию. Эта настройка отличается от общей инструкции об уровне рассуждений, например низком или высоком.
Первая попытка игры исчерпала разрешённые 16 384 токена во время планирования. Повтор применил бюджет размышлений 8 000 токенов и выдал код. Это подтверждает пользу ограниченной фазы рассуждений для такой нагрузки. Это не доказывает, что 8 000 является лучшей настройкой для каждой задачи.
Оставшийся лимит вывода является максимумом, а не гарантированным резервом. Если бы лимит 8 000 токенов был полностью израсходован при общем лимите 16 384, до прочих накладных расходов осталось бы около 8 384 токенов. Журнал результатов сообщает о 11 054 записанных токенах в повторе без полного разделения рассуждений и кода. Не трактуйте это как 8 000 токенов рассуждений плюс 11 054 токена кода в рамках того же лимита.
Для узких изменений используйте меньший бюджет, а для задач, требующих большего анализа, проверяйте большие бюджеты. Изучайте полный вывод файла, статус завершения и результаты тестов. Более длительное планирование полезно только тогда, когда улучшает результат.
Подключите Strata и OpenCode
git clone https://github.com/Niko1221/Strata.git
cd Strata
./setup.sh
Это точка входа для настройки Linux. Изучите актуальные инструкции установки и используйте START-HERE.bat для документированного пути Windows. Выберите исходный вариант Qwen3.8-Flash-Next IQ3_S и контекст 65 536 токенов, чтобы приблизиться к заявленной конфигурации. Сохраните версию движка и выбранные файлы модели в заметках теста.
npm install -g opencode-ai
Установите OpenCode по
официальным инструкциям
. В отдельном терминале определите STRATA_BASE_URL как локальную базу API, показанную Strata, включая суффикс /v1. В этой конфигурации держите вывод привязанным к локальному компьютеру.
{
  "provider": {
    "strata": {
      "npm": "@ai-sdk/openai-compatible",
      "name": "Strata local",
      "options": {
        "baseURL": "{env:STRATA_BASE_URL}",
        "apiKey": "local"
      },
      "models": {
        "qwen3.8-flash-next-iq3_s": {
          "name": "Qwen3.8-Flash-Next IQ3_S",
          "limit": { "context": 65536, "output": 16384 }
        }
      }
    }
  },
  "model": "strata/qwen3.8-flash-next-iq3_s"
}
Объедините блок провайдера с ~/.config/opencode/opencode.json, сохранив существующие настройки. Это адаптация
опубликованного примера конфигурации
, где локальная конечная точка загружается из переменной окружения. OpenCode документирует
пользовательские провайдеры
и
подстановку переменных окружения
.
local является заменителем учётных данных, как в примере локальной настройки без аутентификации. Он не защищает сервер. Если экземпляр Strata включает аутентификацию, передайте настроенные учётные данные через подходящий локальный механизм секретов.
Запустите opencode в отдельной копии проекта и выберите настроенную модель. Проверьте выбранного провайдера перед отправкой кода. Объявление контекста на стороне клиента не увеличивает контекст сервера, а окно 65 536 токенов не оставляет 65 536 токенов для ввода, если нужно место и для вывода.
Локальный вывод и разрешения
{
  "permission": {
    "edit": "ask",
    "bash": "ask"
  }
}
Объедините эти начальные разрешения с конфигурацией OpenCode во время оценки агента. Документация разрешений объясняет доступные средства контроля. Изменение файлов и выполнение команд оболочки влияет на компьютер независимо от места выполнения вывода.
Локальный вывод не делает каждый инструмент локальным. Загрузка пакетов, веб-инструменты, внешние интеграции и необязательный обмен всё ещё используют сетевые службы. Перед работой с приватными репозиториями проверьте включённые инструменты. «Модель работает локально» уже, чем «ничего не покидает компьютер».
Устранение проблем при первом запуске
| Симптом | Что проверить сначала |
|---|---|
| Провайдер недоступен | Strata работает, а переменная окружения передаётся процессу OpenCode |
| Модель отсутствует в списке | Идентификаторы провайдера и модели совпадают с сохранённой конфигурацией |
| Ошибка лимита контекста | Длина промпта и запрошенный вывод помещаются в активное окно сервера |
| Планирование без кода | Бюджет рассуждений, общий лимит вывода и статус завершения |
| Медленное продолжение | Повторное использование префикса, давление на память, работа кэша экспертов и конкурирующие процессы |
| Команда Docker завершается ошибкой | Есть работающий движок, а не только его клиент командной строки |
Меняйте по одной настройке и повторяйте ту же задачу из сохранённого исходного состояния. Так улучшение конфигурации отделяется от другого промпта или более лёгкого теста.
Заменяет ли это подписку?
| Локальную конфигурацию стоит проверить | Оставьте другой вариант |
|---|---|
| Уже имеющееся совместимое оборудование | Покупка оборудования только для непроверенной нагрузки |
| Ограниченные изменения приложения | Большие незнакомые репозитории и сложные миграции |
| Повторяемые приёмочные тесты | Задачи без надёжной проверки корректности |
| Время на обслуживание среды выполнения | Работа с минимальными требованиями к настройке и поддержке |
Нулевые расходы API важны, особенно когда оборудование уже доступно. Они исключают электричество, амортизацию оборудования, хранилище и время обслуживания среды. Отображаемое поле нулевой стоимости также не учитывает эти расходы.
Сравнение подписок требует одинаковых задач. Запустите один и тот же исходный репозиторий, инструкции и приёмочные проверки в обеих системах. Записывайте повторы и исправления человека вместе с прошедшим временем. При оценке полного процесса включите неудачную первую попытку игры, а не только успешный повтор.
Полезному локальному агенту не требуется превосходство во всём. Если он надёжно выполняет обычные изменения и оставляет небольшой набор сложных задач другому инструменту, он уже меняет потребность в платных сервисах. Принимайте решение по принятой работе в собственных проектах.
Демонстрация и следующие шаги
Дополнительный просмотр: Демонстрация локального агента программирования 125B . Приведённые выше измерения относятся к опубликованному тесту, а не к независимому бенчмарку для этой статьи.
- Повторите одну небольшую задачу с фиксированными критериями приёмки и сохранённой исходной ревизией.
- Измерьте холодные и тёплые ходы, а не принимайте повторное использование префикса за скорость холодного prefill.
- Проверьте упаковку отдельно успешной сборкой образа, запуском и проверками внутри контейнера.
- Изучите сгенерированные тесты и добавьте случаи, которые реализация не предусмотрела.
- Сравните завершённую работу с текущим инструментом программирования до смены подписок.
Для планирования оборудования прочитайте руководство по локальным моделям ИИ и контексту GPU . О поведении размещённых моделей смотрите маршрутизацию провайдеров OpenRouter и стоимость .
Related Posts